El archivo que supera todas las comprobaciones
Los flujos de trabajo de seguridad de archivos se basan en una suposición que rara vez se cuestiona: un archivo tiene un único tipo. El detector lo identifica y la política lo deriva. A continuación, todos los motores posteriores analizan el archivo según ese tipo: antimalware, entorno aislado y desinfección.
Los archivos «polyglot» rompen con esta suposición. Un único flujo de bytes puede ser a la vez un archivo GIF perfectamente válido y un archivo Java perfectamente válido. El mismo truco funciona con un archivo JPEG que también es un archivo RAR, o con un PDF que contiene un archivo ZIP completo más allá de su final lógico. Cada parte cumple por sí sola con los estándares, por lo que ningún analizador de formato individual detecta ningún error.
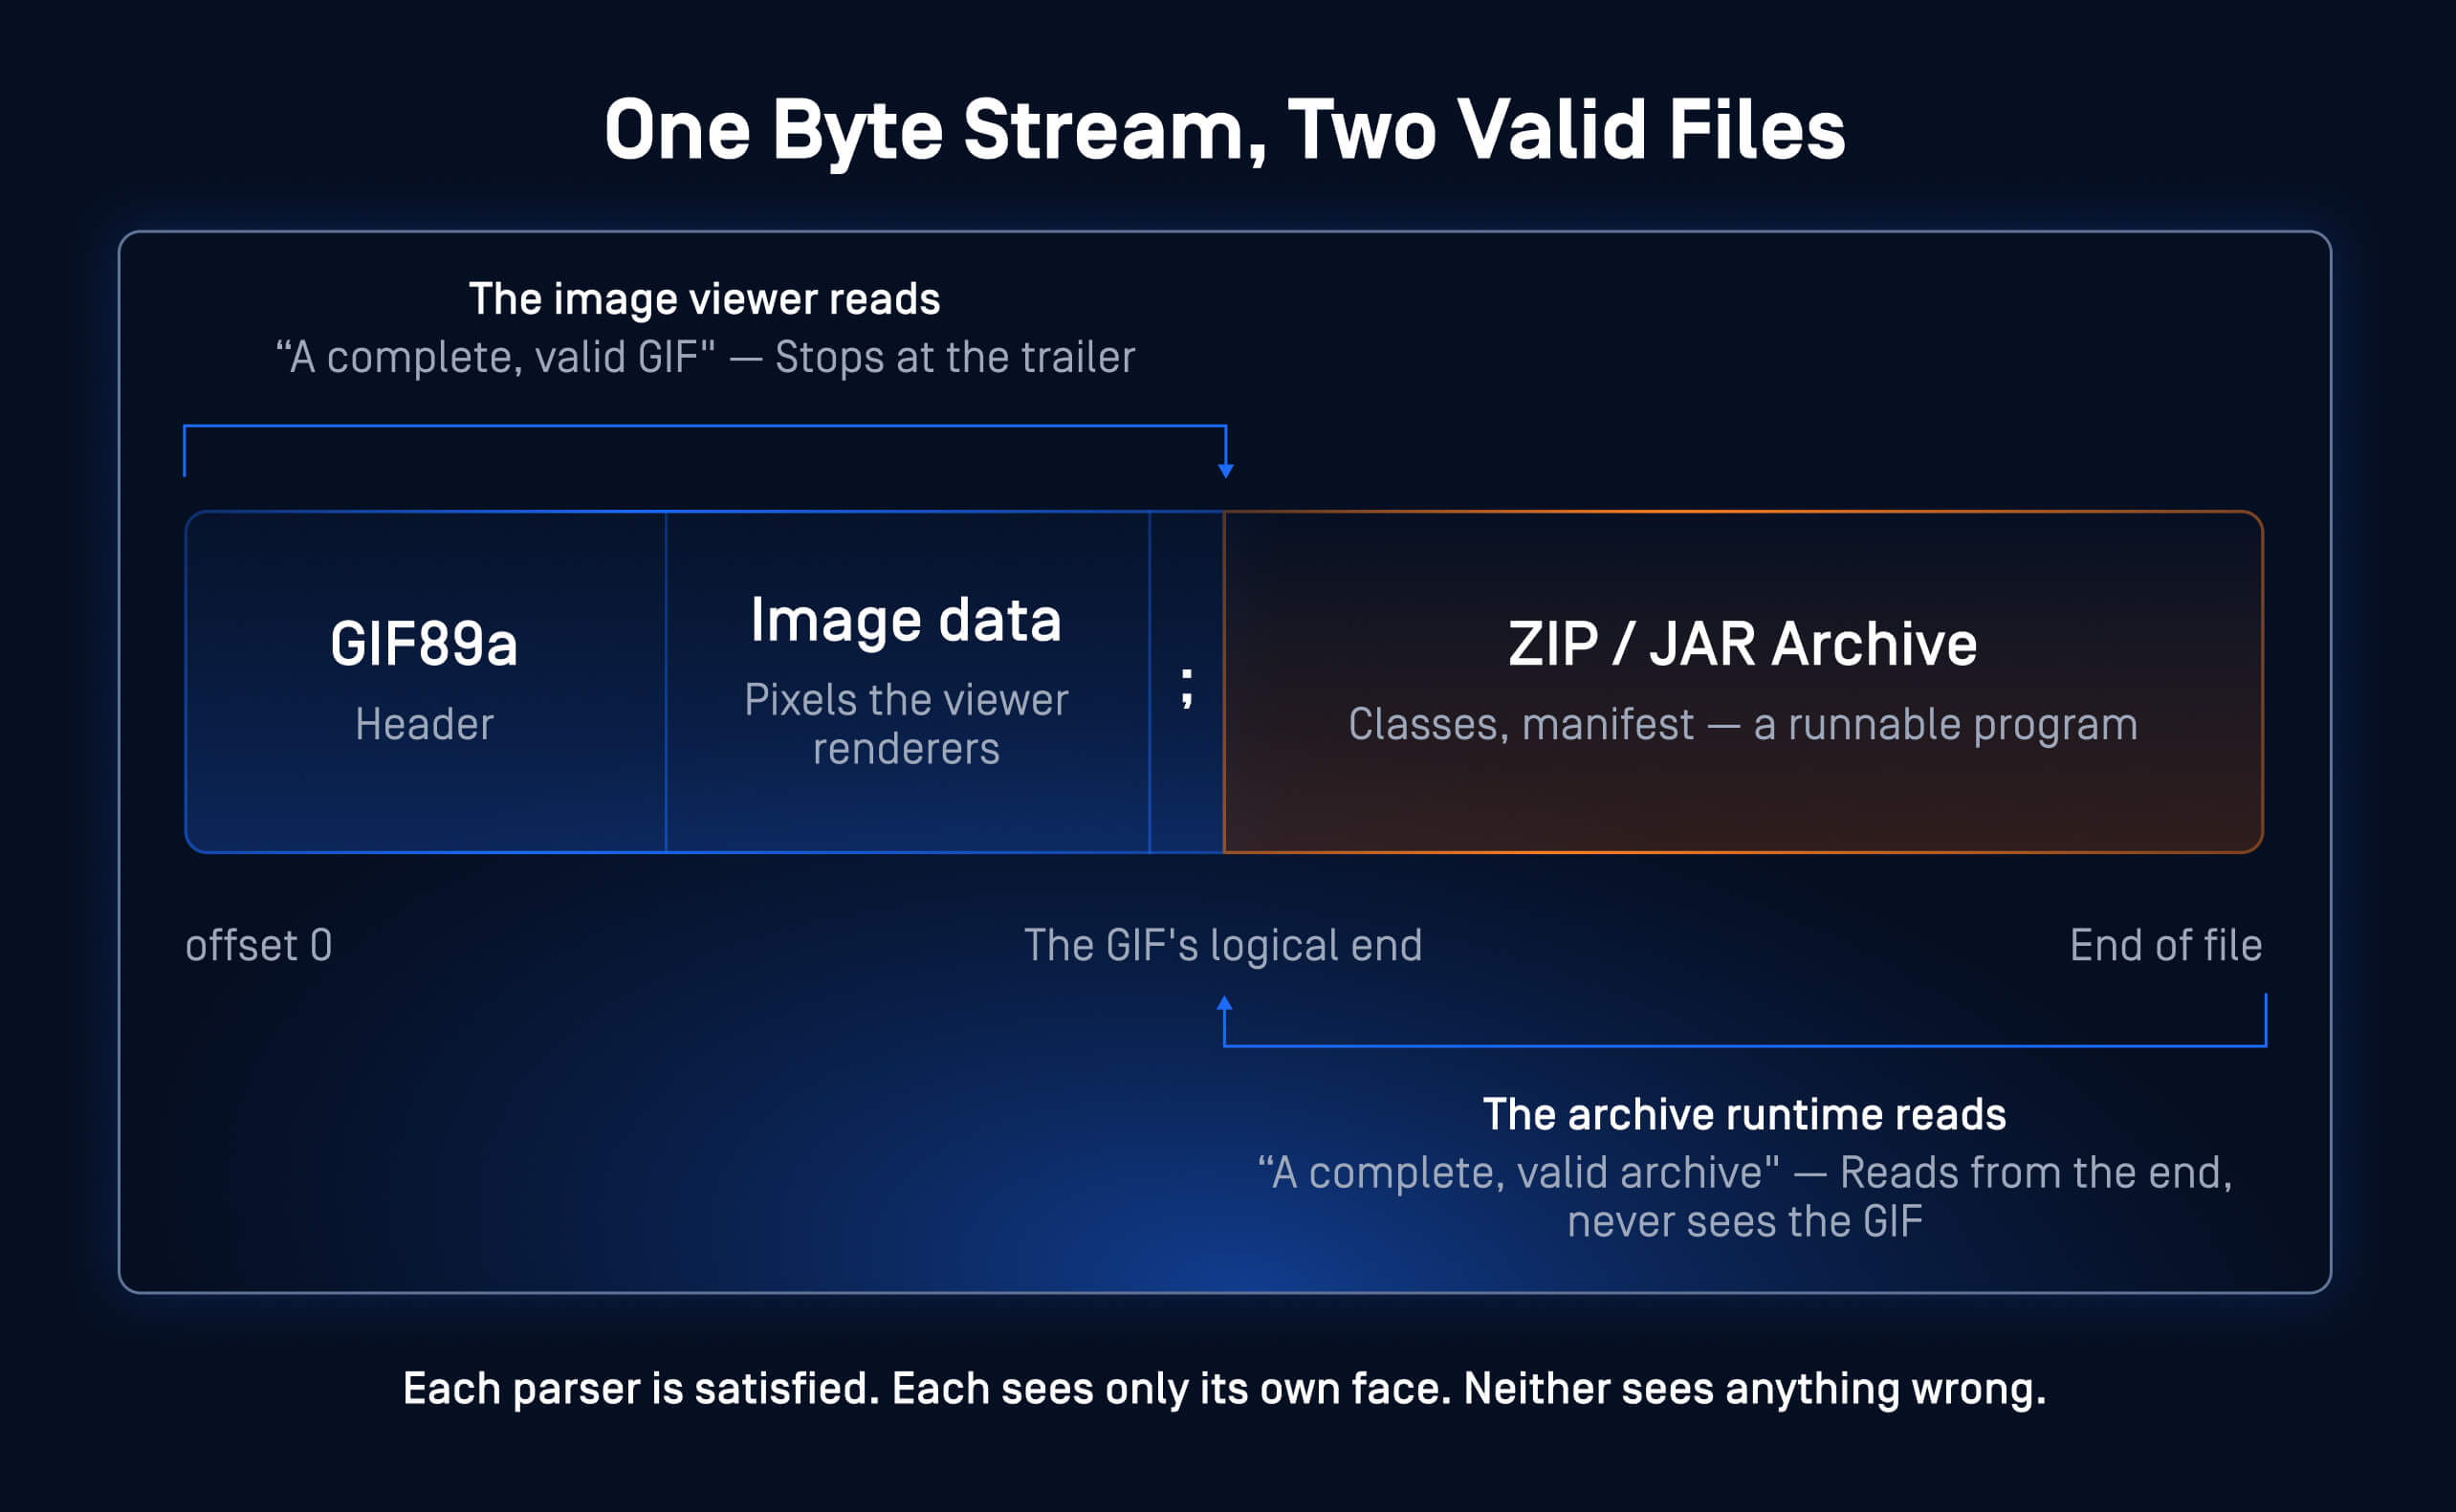
Un políglota en una sola imagen: el clásico GIF+JAR. Dos analizadores sintácticos, dos puntos de entrada, un solo archivo y cada cara totalmente válida.
La consecuencia en materia de seguridad es clara: el canal procesa el archivo según el tipo que ha detectado, mientras que el otro formato pasa sin ser alterado. Una imagen que también es un script se convierte en un XSS almacenado cuando una aplicación web la muestra al usuario. Un archivo oculto tras la superficie de una imagen hace pasar su carga útil a través de los filtros de contenido. Las cadenas de ataque basadas en esta idea, desde la clásica combinación GIF+JAR hasta la entrega de exploits asistida por esteganografía, son de dominio público desde hace casi dos décadas. Los motores antimalware siguen sin detectarlas en su mayor parte porque cada elemento, inspeccionado de forma independiente, es inofensivo.
Cómo el motor descubre una segunda faceta
Nuestro motor de validación de la estructura de archivos incorpora la detección de formatos múltiples como un paso de preprocesamiento que se ejecuta en cada archivo analizado, antes de cualquier procesador de formatos. El diseño se basa en tres ideas.
- Analiza todo el flujo de datos. El escáner compara el archivo completo con una lista de firmas mágicas de formato. Si aparece un segundo formato en cualquier punto del flujo de datos, se muestra junto con su desplazamiento exacto, incluso cuando ya se haya detectado un tipo de archivo. Esto incluye las firmas añadidas tras el marcador de fin de archivo de un PDF o ocultas tras los datos de píxeles de una imagen.
- Saber dónde termina legítimamente un formato. Los formatos Container pueden contener legalmente otros archivos en su interior. Una imagen dentro de un ZIP es contenido ordinario. El detector determina el verdadero final de cada contenedor a partir de la propia estructura del mismo. El trailer de un PDF, el directorio central de un ZIP y la asignación de sectores de un archivo compuesto OLE (Object Linking and Embedding) marcan cada uno de esos límites. La resolución del PDF tiene en cuenta las actualizaciones incrementales. Solo las firmas situadas fuera de esa estructura se consideran un segundo límite. Este límite estructural es lo que distingue un veredicto poliglota real de una falsa alarma en cualquier archivo común.
- Confirma antes de acusar. El motor extrae cada posible candidato del flujo de datos y lo vuelve a identificar de forma independiente con nuestro motor de tipos de archivo antes de notificarlo. Los candidatos que se identifican como datos no estructurados se descartan. Un veredicto significa que realmente se analiza un segundo formato en ese punto de la secuencia. Los bytes mágicos aislados por sí solos nunca dan lugar a uno.
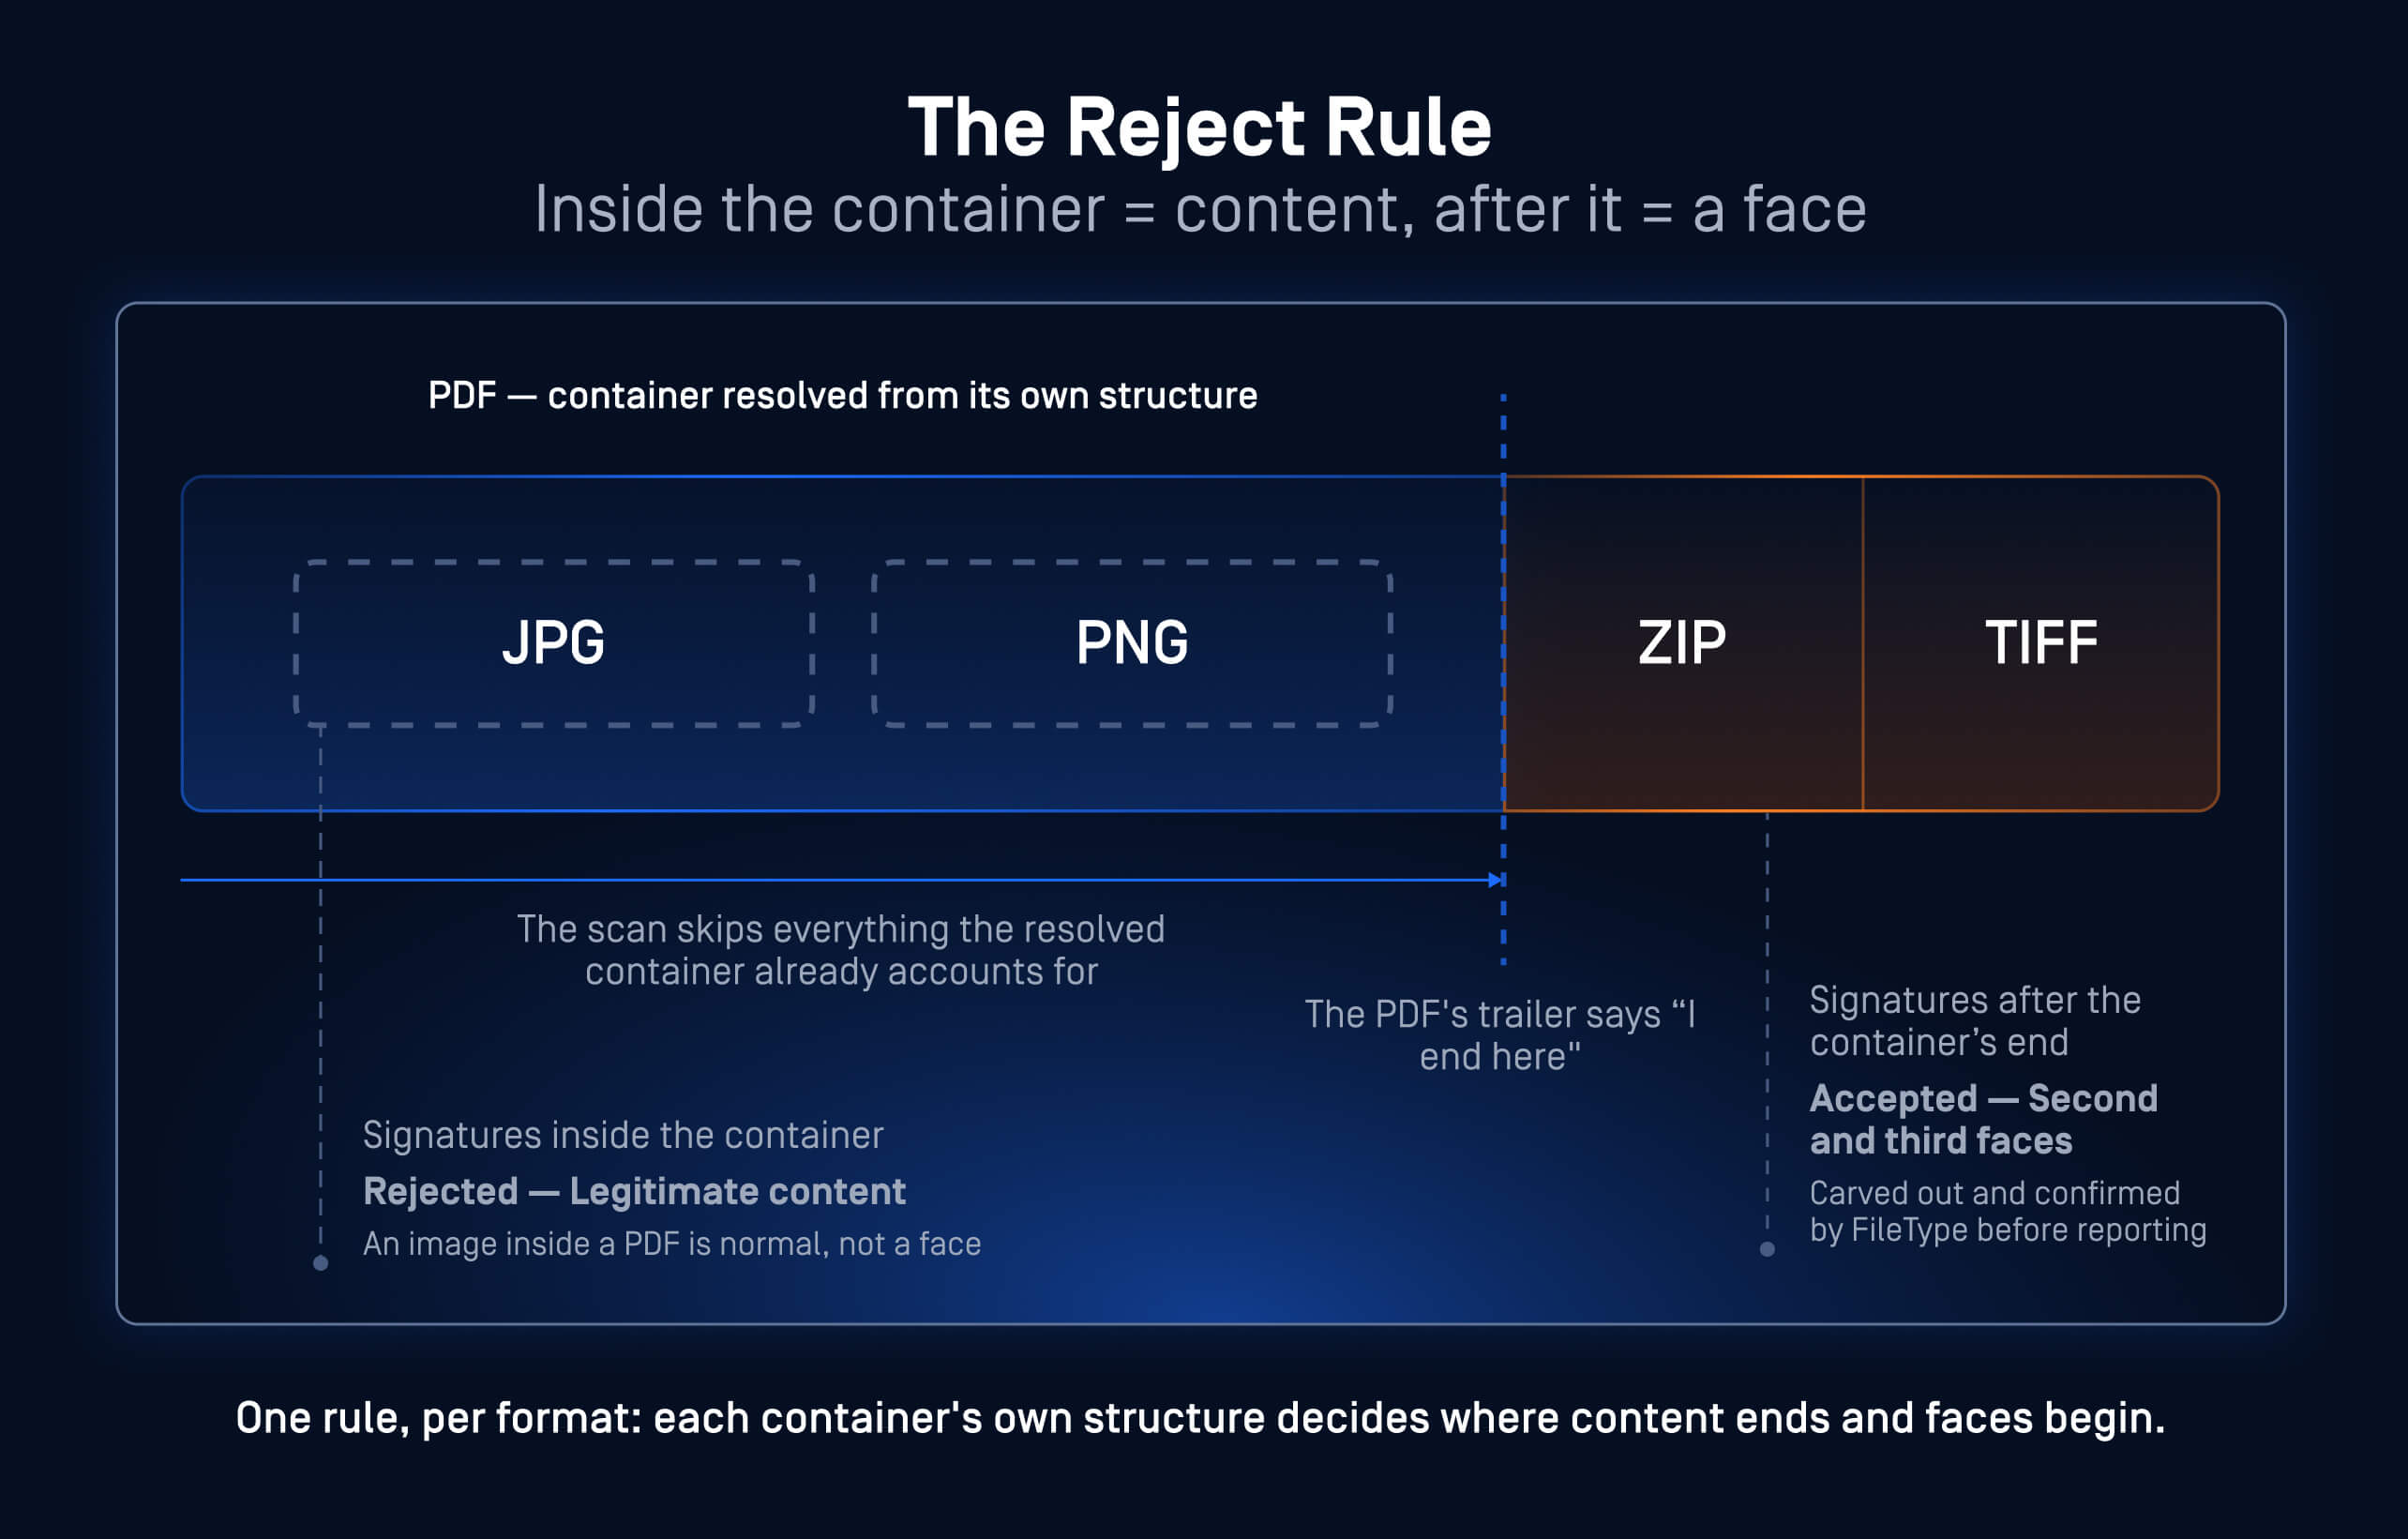
Tomado de un ejemplo real: un PDF que contiene una imagen JPG y otra PNG incrustadas, con un archivo ZIP y un TIFF añadidos al final de su estructura lógica. El resultado identifica el ZIP y el TIFF, pero no menciona las imágenes incrustadas.
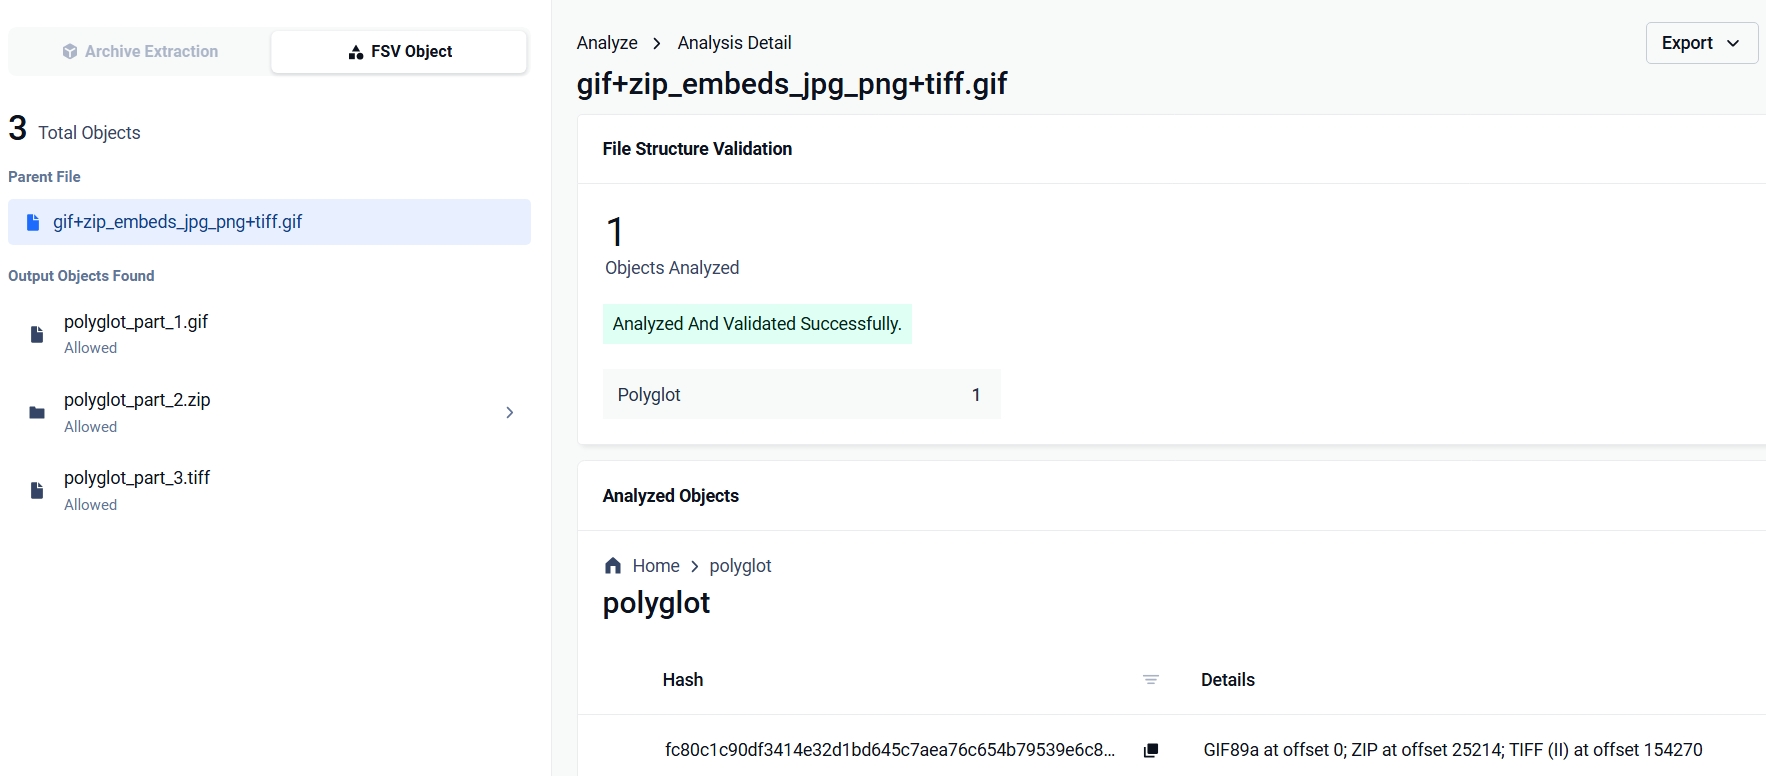
El resultado muestra cada cara con su desplazamiento. Por ejemplo, una sola subida de un archivo .gif se identifica como GIF89a en el desplazamiento 0 y como un archivo ZIP más adelante en el flujo. La política determina el resto: informar del hallazgo o bloquear el archivo directamente con una explicación en la que se enumeren los resultados positivos.
De la detección a la disección
La detección es solo la mitad de la solución, ya que el truco del «polyglot» radica precisamente en que cada cara, por separado, parece inofensiva. Tras la detección, el motor analiza el archivo. Cada cara confirmada se exporta como un objeto independiente (polyglot_part_1.pdf, polyglot_part_2.zip, etc.) con su formato, desplazamiento y tamaño. El motor devuelve cada uno de ellos al flujo de trabajo deMetaDefender Core™ para su procesamiento completo según lo que realmente es.
Lo hemos comprobado de principio a fin en una instancia activa de MetaDefender Core™.
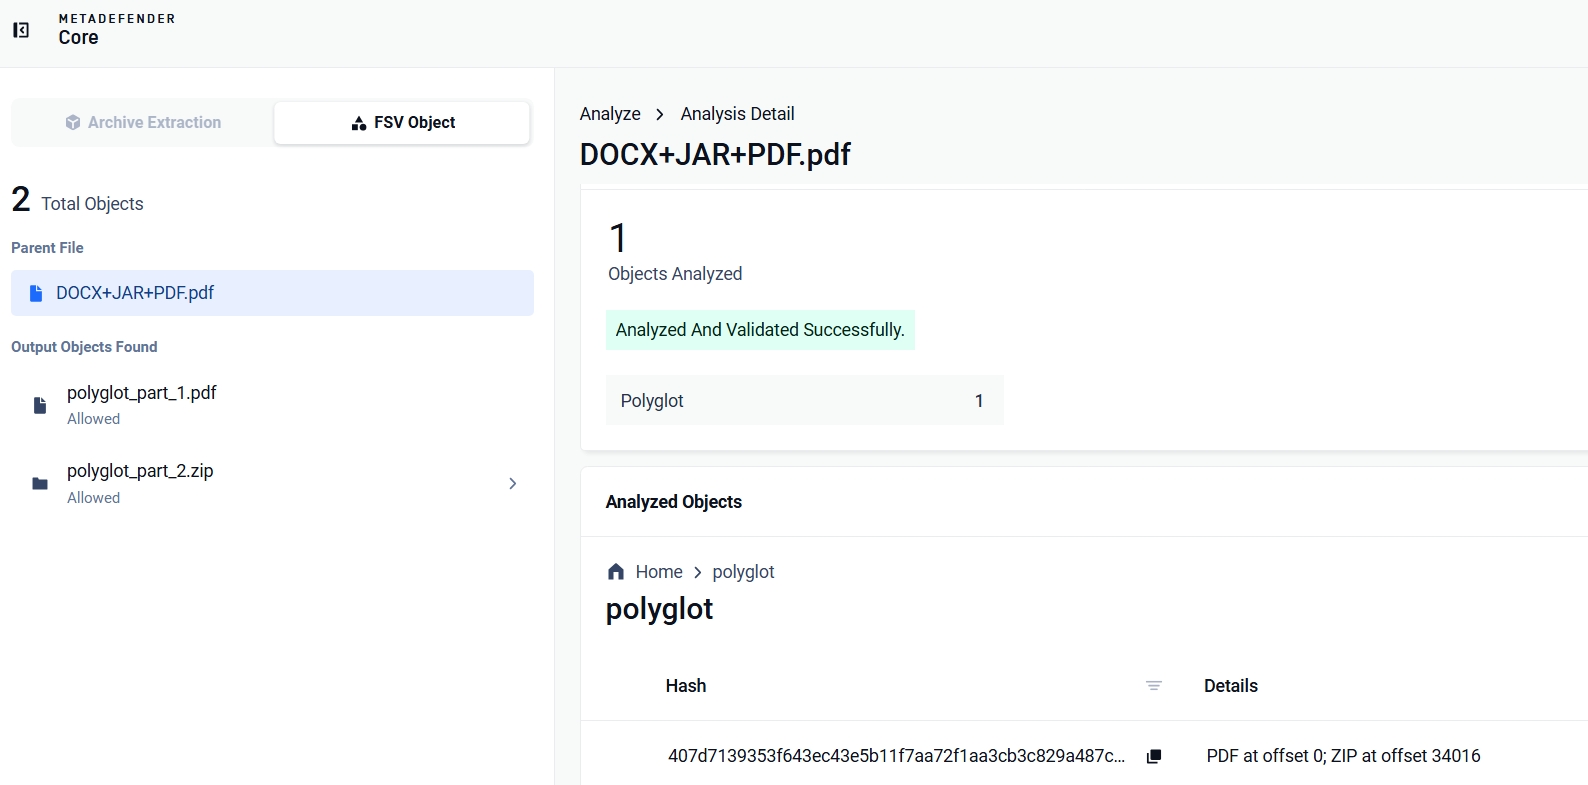
El motor dividió una muestra de PDF que ocultaba un documento de Word (un archivo multiformato PDF+JAR+DOCX) en su parte de PDF y su parte ZIP. Dado que tanto JAR como DOCX son contenedores ZIP, una sola parte ZIP cumple ambas especificaciones. A continuación, el motor de tipos de archivo identificó esa parte como un DOCX, y la tecnología Deep CDR™ la depuró por separado. La parte oculta recibe el mismo tratamiento que se había diseñado para eludir.
La precisión es lo más difícil
Los «bytes mágicos» aparecen de forma natural en archivos inofensivos, por lo que la verdadera inversión en ingeniería consiste en no dar falsas alarmas. Las fotos tomadas con una cámara incorporan miniaturas EXIF que contienen su propia firma JPEG. Los documentos de Office incorporan imágenes dentro de su estructura contenedora. Los archivos « Media » contienen aleatoriamente secuencias de bytes que se asemejan a encabezados de compresión. La lógica de detección excluye los bytes que ya están justificados por una estructura legítima, y este refuerzo se amplía continuamente, formato a formato. Un detector que marca todas las fotos de cámara se desactiva, y un detector desactivado no protege a nadie.
Probado con políglotas reales
Hemos procesado muestras poliglotas reales en una implementación en vivo de MetaDefender Core™ con el motor de validación de la estructura de archivos. Se detectaron todas ellas, y se identificó la ubicación exacta de cada una en el byte correspondiente:
Ejemplo | Caras encontradas (desplazamiento) | Resultado |
PDF que oculta un documento de Word (PDF+JAR+DOCX en un solo archivo) | PDF: 0 · ZIP: 34 016 | Se han extraído los datos personales; el archivo DOCX oculto se ha depurado mediante la tecnología Deep CDR™. |
GIF que oculta un archivo y una segunda imagen | GIF89a @ 0 · ZIP @ 25 214 · TIFF @ 154 270 | Detectado |
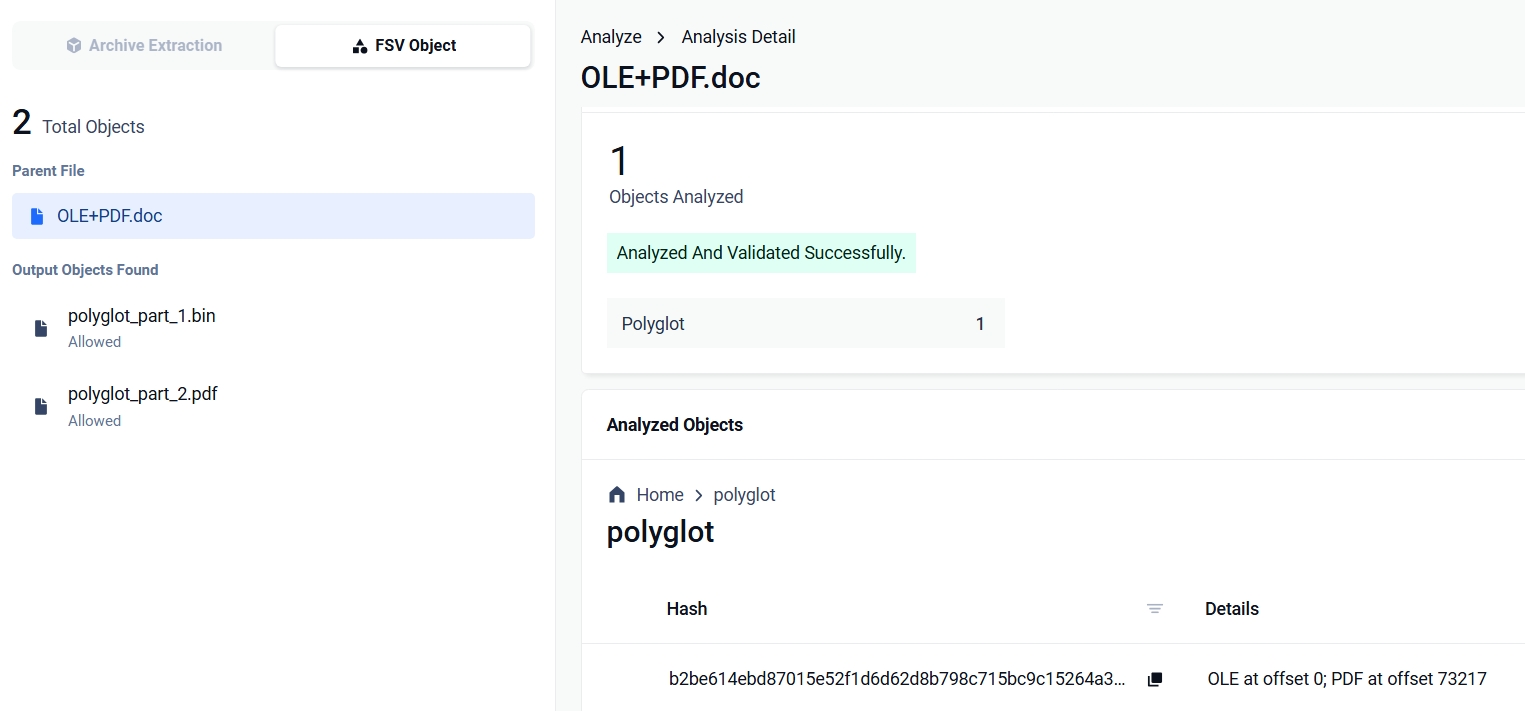
Documento de Office que oculta un PDF | OLE @ 0 · PDF @ 73 217 | Detectado |
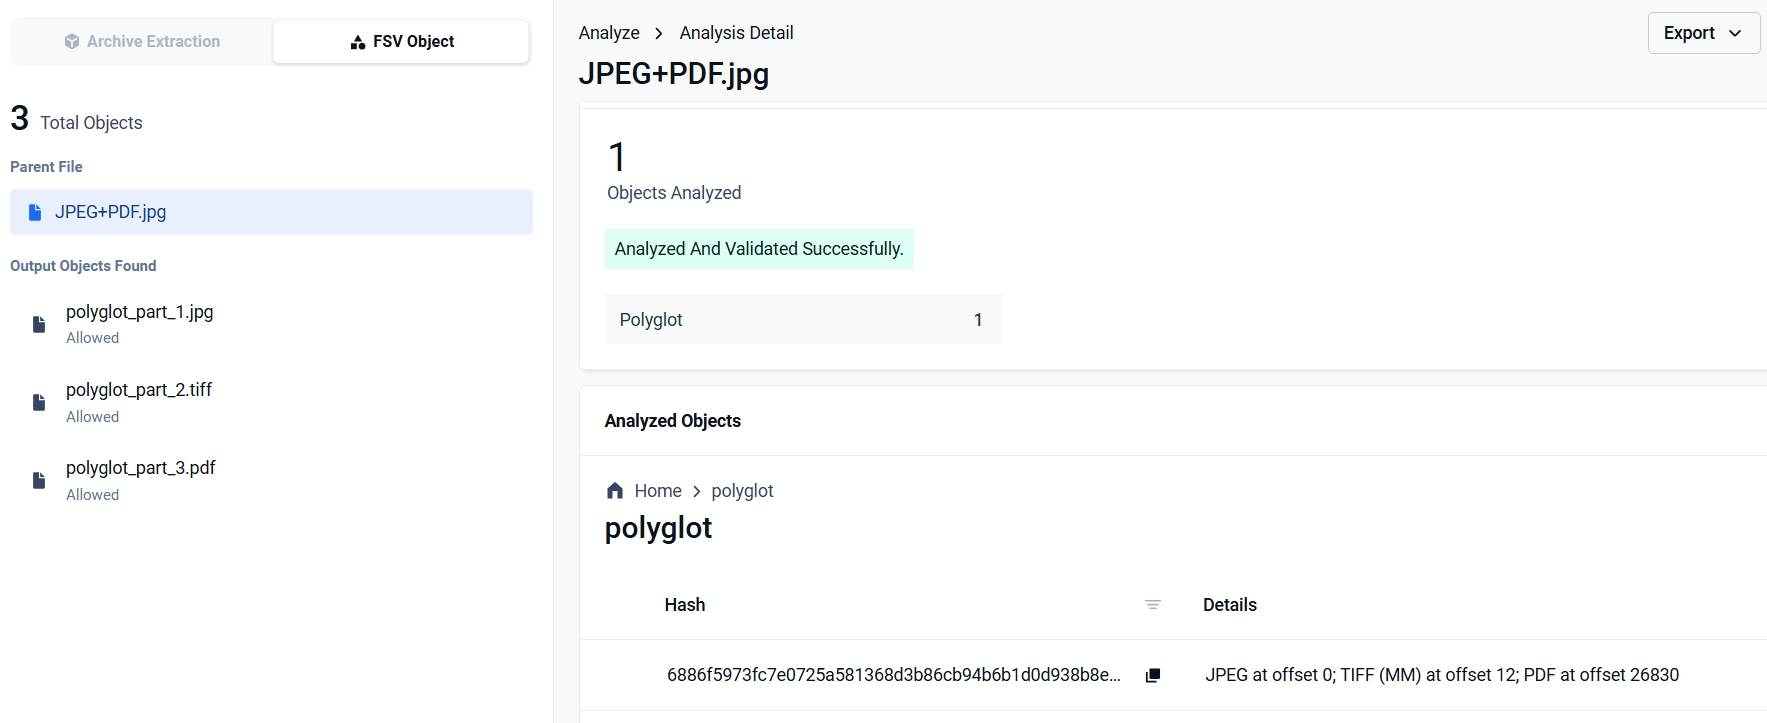
Un archivo JPEG que oculta un PDF | Tres caras, PDF adjunto @ 26 830 | Detectado |
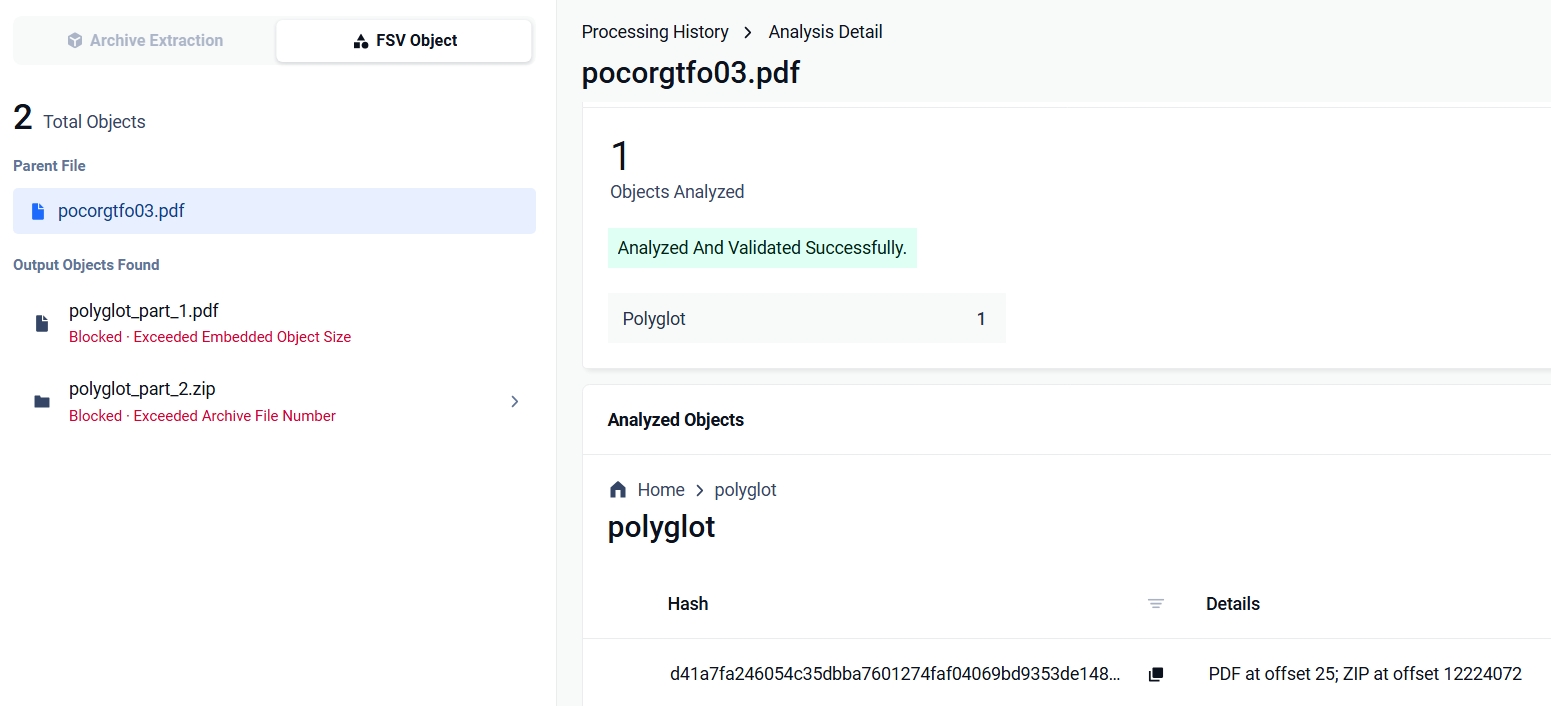
«PoC‖GTFO», número 3, la revista sobre investigación en seguridad en formato PDF+ZIP multilingüe, 26 MB | PDF: 25 · ZIP: 12 224 072 | Detectado: se ha encontrado una segunda cara a 12 MB de profundidad tras un análisis completo |
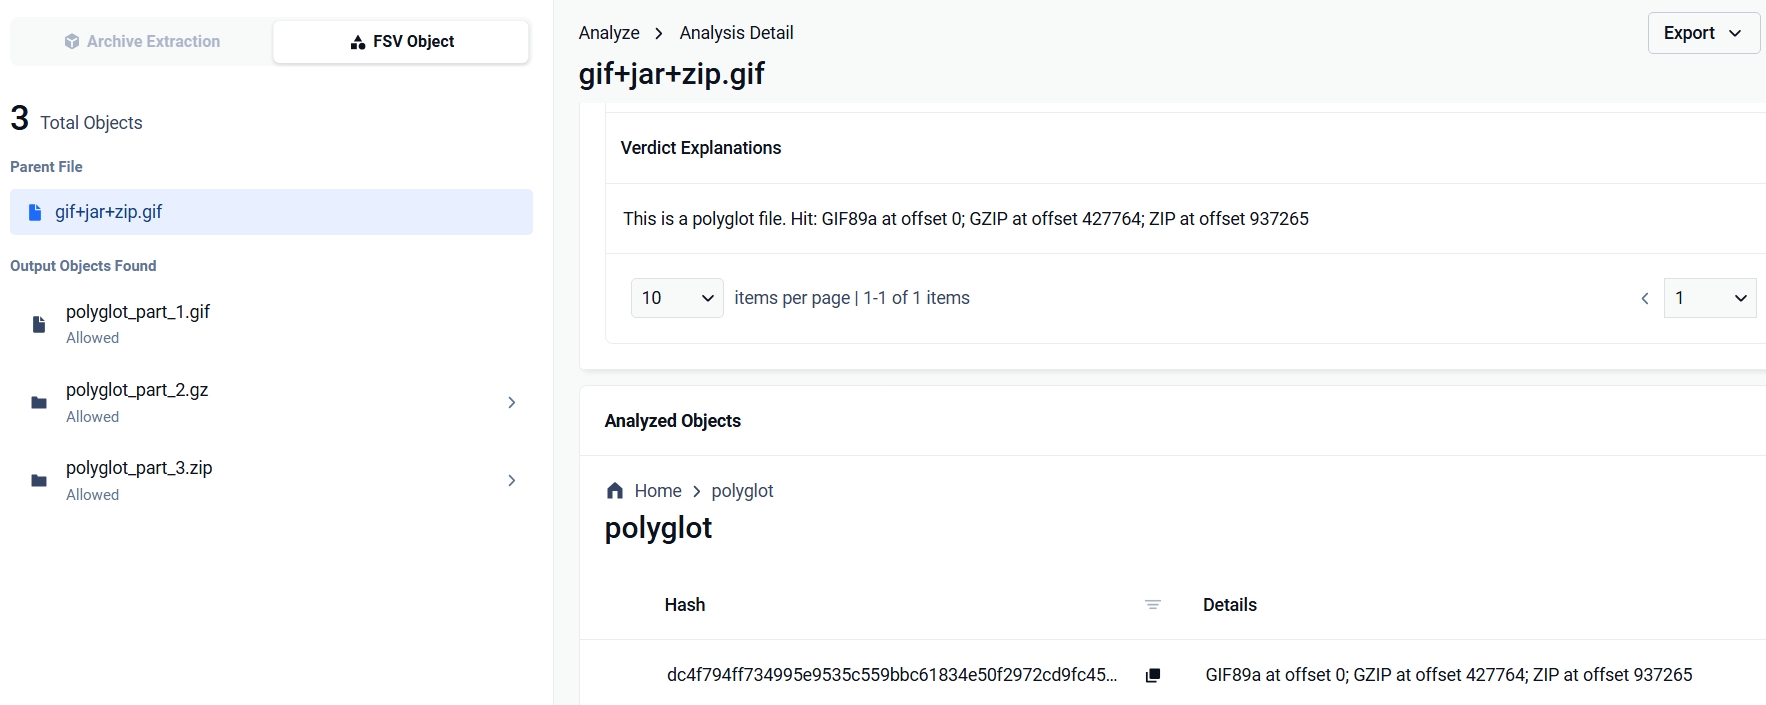
GIF que contiene un flujo GZIP y un archivo Java | GIF89a @ 0 · GZIP @ 427 764 · ZIP @ 937 265 | Bloqueado |
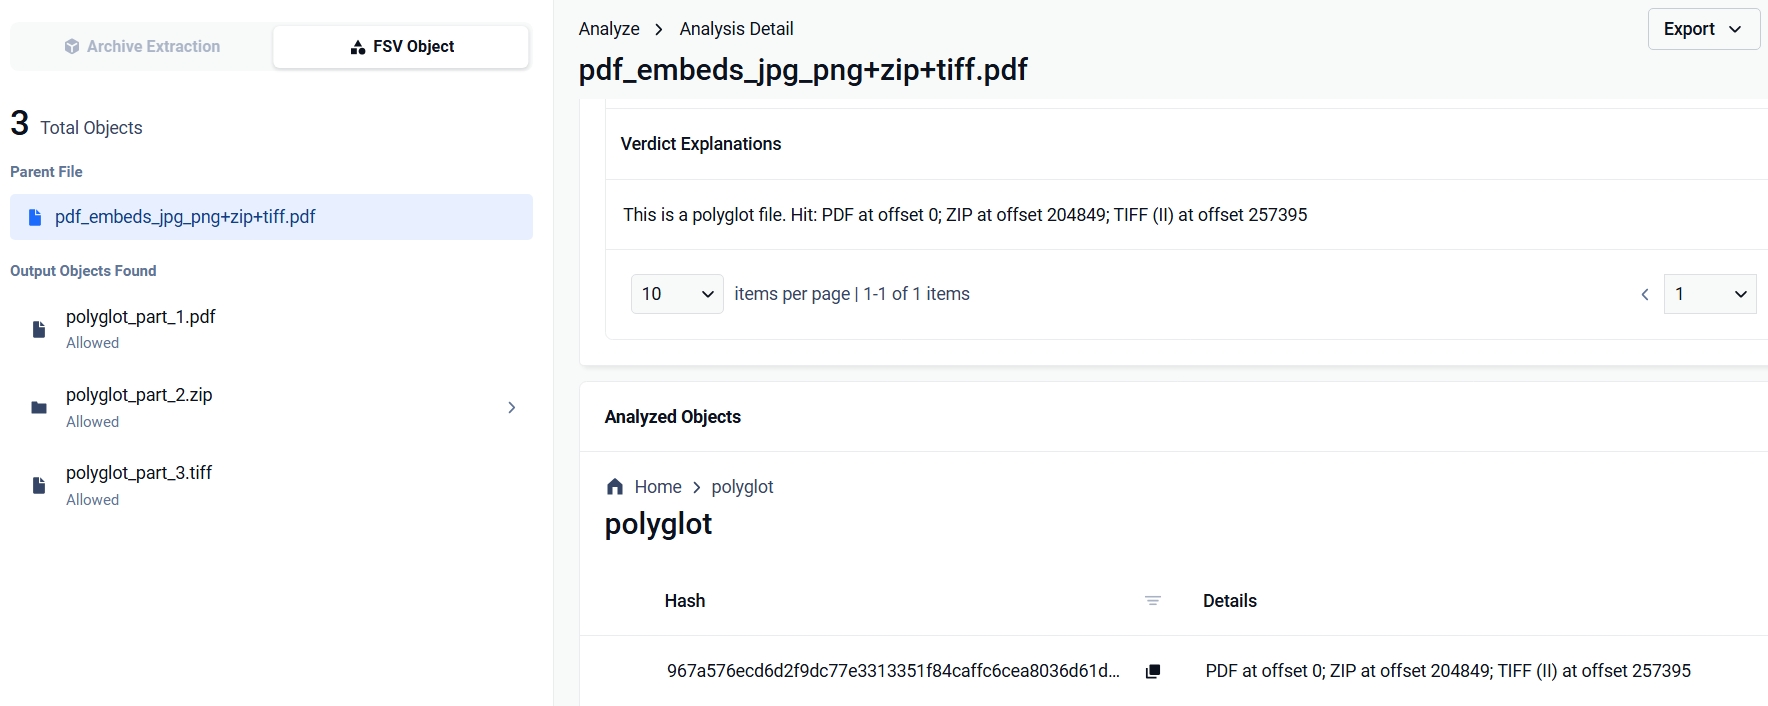
Archivo PDF que contiene un JPG y un PNG, con un ZIP y un TIFF adjuntos | PDF: 0 · ZIP: 204 849 · TIFF: 257 395 | Bloqueado; las imágenes incrustadas no se han mostrado correctamente. |
La última línea muestra cómo funciona la regla de rechazo: el veredicto identifica los archivos ZIP y TIFF adjuntos e ignora las imágenes contenidas en el PDF. El resolutor de contenedores las consideró parte del contenido del propio PDF. JSON del resultado de MetaDefender Core™ para ese archivo (resumido):
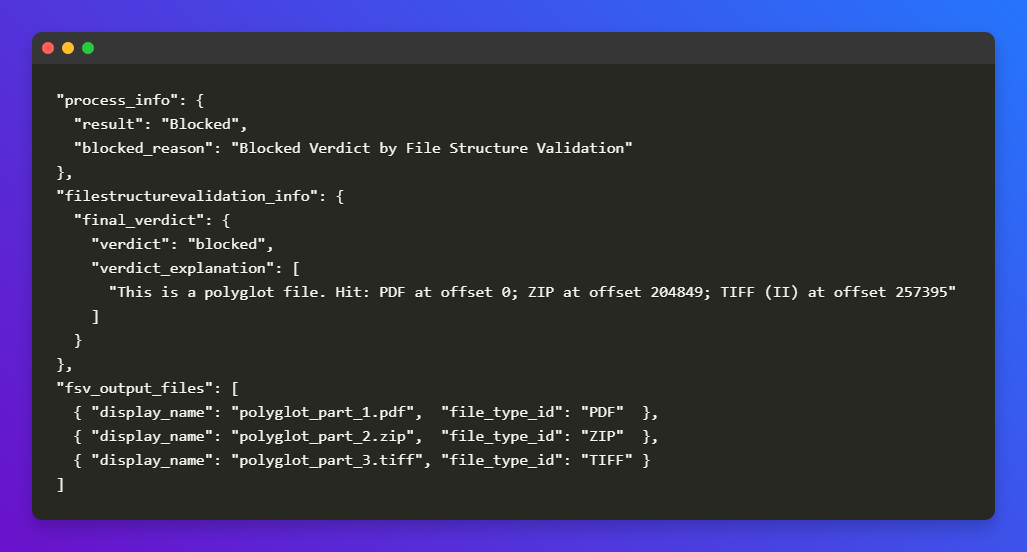
La lista «fsv_output_files» es la disección descrita anteriormente, en tiempo real: las tres caras extraídas y devueltas al flujo de trabajo como objetos independientes.
A continuación se muestran las capturas de pantalla de cada resultado de muestra en MetaDefender Core™:
Cobertura y configuración
Actualmente, la cobertura abarca los formatos que los atacantes combinan realmente: PDF, ZIP, archivos compuestos OLE, PNG, GIF, JPEG, TIFF, RAR, GZIP y 7z.
La resolución estructural de «fin de contenedor» se aplica a los formatos de contenedor. La función se implementa siguiendo el principio de «primero la configuración»: la detección, el bloqueo y el análisis completo de archivos son, cada uno de ellos, opciones de política, por lo que los operadores eligen entre visibilidad y aplicación de la política en cada implementación.
En resumen
Un archivo con dos tipos válidos burla cualquier proceso que le asigne un único tipo, y la detección de un solo tipo es la base sobre la que se construyen la mayoría de las pilas de análisis. La detección estructural «poliglota» subsana esa deficiencia al identificar todas las caras y demostrar que cada una de ellas se analiza correctamente. De este modo, la política puede bloquear el archivo antes de que alguna aplicación elija el intérprete incorrecto.
Actualmente se admite la detección de los formatos de ataque más habituales. La resolución del «fin de contenedor» para los formatos de archivo restantes está prevista en la hoja de ruta.
Descubre cómo la validación de la estructura de archivos gestiona los formatos de archivo que circulan por tu entorno.