En junio de 2025, Cisco dio a conocer la vulnerabilidad CVE-2025-20282, una vulnerabilidad de máxima gravedad en su Identity Services Engine. La causa principal fue la ausencia de un control de validación de archivos en el punto de carga, lo que podía permitir a un atacante no autenticado colocar un archivo manipulado en un directorio con privilegios y ejecutarlo como root. El fallo se producía antes de la detección, es decir, en la fase en la que el sistema aceptaba el archivo antes de que se ejecutara ningún motor de análisis.
Ese patrón no es exclusivo de un solo producto. El número de motores en una pila rara vez supone una limitación. Un archivo debe analizarse antes de poder evaluarse, y los formatos modernos anidan el contenido de formas que el análisis no siempre alcanza.
¿Por qué el resultado de la exploración fue normal?
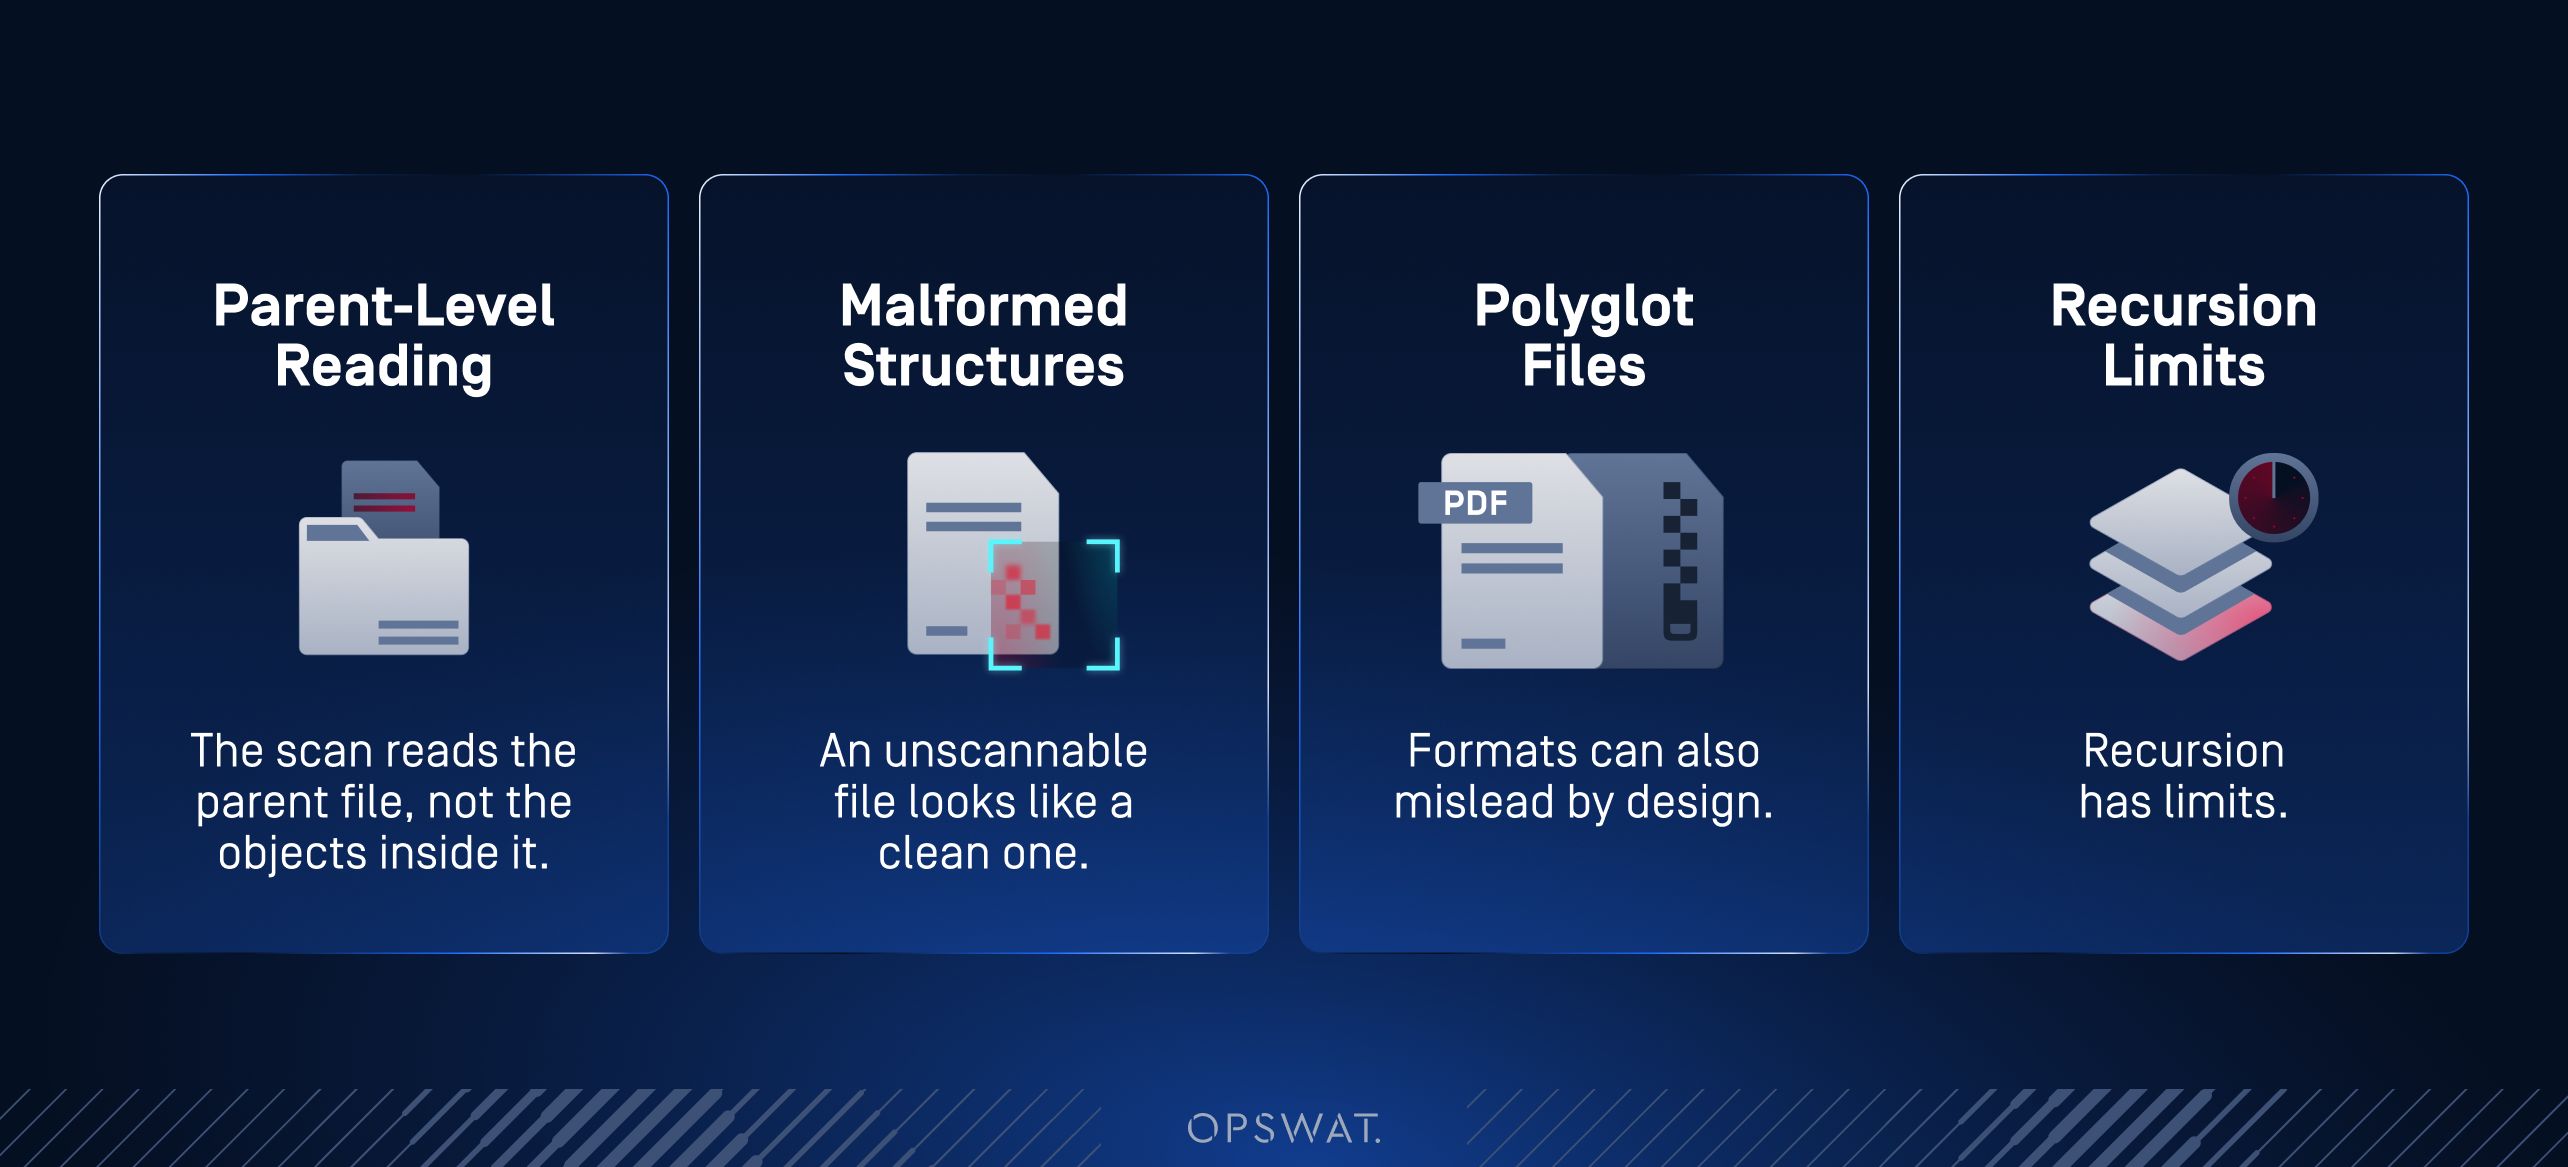
El análisis basado en firmas funciona comparando bytes. Un motor dispone de una base de datos de hash y patrones de bytes extraídos de malware conocido, y para que un archivo sea detectado debe presentar bytes que coincidan con los de dicha base de datos. Hay varios factores que impiden que esto ocurra con el contenido anidado.
- El análisis lee el archivo principal, no los objetos que contiene. Un análisis considera el archivo que tiene delante como un único objeto binario y lo compara con la base de datos de firmas. El contenido anidado se almacena en formato comprimido o codificado, por lo que un ejecutable situado dentro de un flujo de datos de un documento no comparte prácticamente ninguna secuencia de bytes con el mismo ejecutable que se encuentra en el disco. El patrón que busca la base de datos no está presente en el archivo tal y como está almacenado, y solo puede compararse una vez que se descomprime dicho flujo.
- Un archivo que no se puede analizar tiene el mismo aspecto que uno limpio. Una estructura defectuosa interrumpe el análisis. El motor no puede completar su evaluación, por lo que el archivo se omite en lugar de bloquearse, y se transmite un resultado que significa «no se ha podido evaluar», indistinguible de un resultado que signifique «no se ha encontrado nada».
- Los formatos también pueden inducir a error por su propio diseño. Un archivo poliglota cumple dos especificaciones de formato a la vez, por lo que un analizador sintáctico lo interpreta como tal, mientras que el archivo se comporta como algo completamente distinto.
- La recursión tiene límites. Los contenedores anidados están sujetos a límites de profundidad y tiempos de espera de exploración, y con razón, ya que la recursión ilimitada supone en sí misma un riesgo de denegación de servicio. Una carga útil situada por debajo de ese límite nunca se evalúa, y situarse a una profundidad mayor de la que alcanza el motor requiere mucho menos esfuerzo que burlarlo.
El resultado es un veredicto que dice menos de lo que parece. Un resultado «limpio» significa que no se ha encontrado ningún patrón conocido en la parte del archivo que el motor ha podido analizar. No dice nada sobre los componentes que hay dentro del archivo, ni sobre las capas que el motor no ha abierto.
Cada capa tiene una función. Faltaba una.
El análisis basado en firmas nunca actúa de forma aislada. Las estructuras modernas de seguridad de archivos suelen estar diseñadas en capas, y las capas que lo rodean sirven para cubrir lo que la comparación de patrones no puede abarcar.
La identificación del tipo de archivo determina el tipo real de un archivo a partir de su encabezado, en lugar de su extensión declarada. Es un método rápido y superficial por diseño, concebido para decidir dónde se almacena un archivo, más que para determinar su contenido. El análisis dinámico observa el comportamiento del archivo en un entorno controlado. Es la herramienta adecuada para amenazas desconocidas y resulta más eficaz cuando se aplica de forma selectiva, en lugar de a todos los archivos.
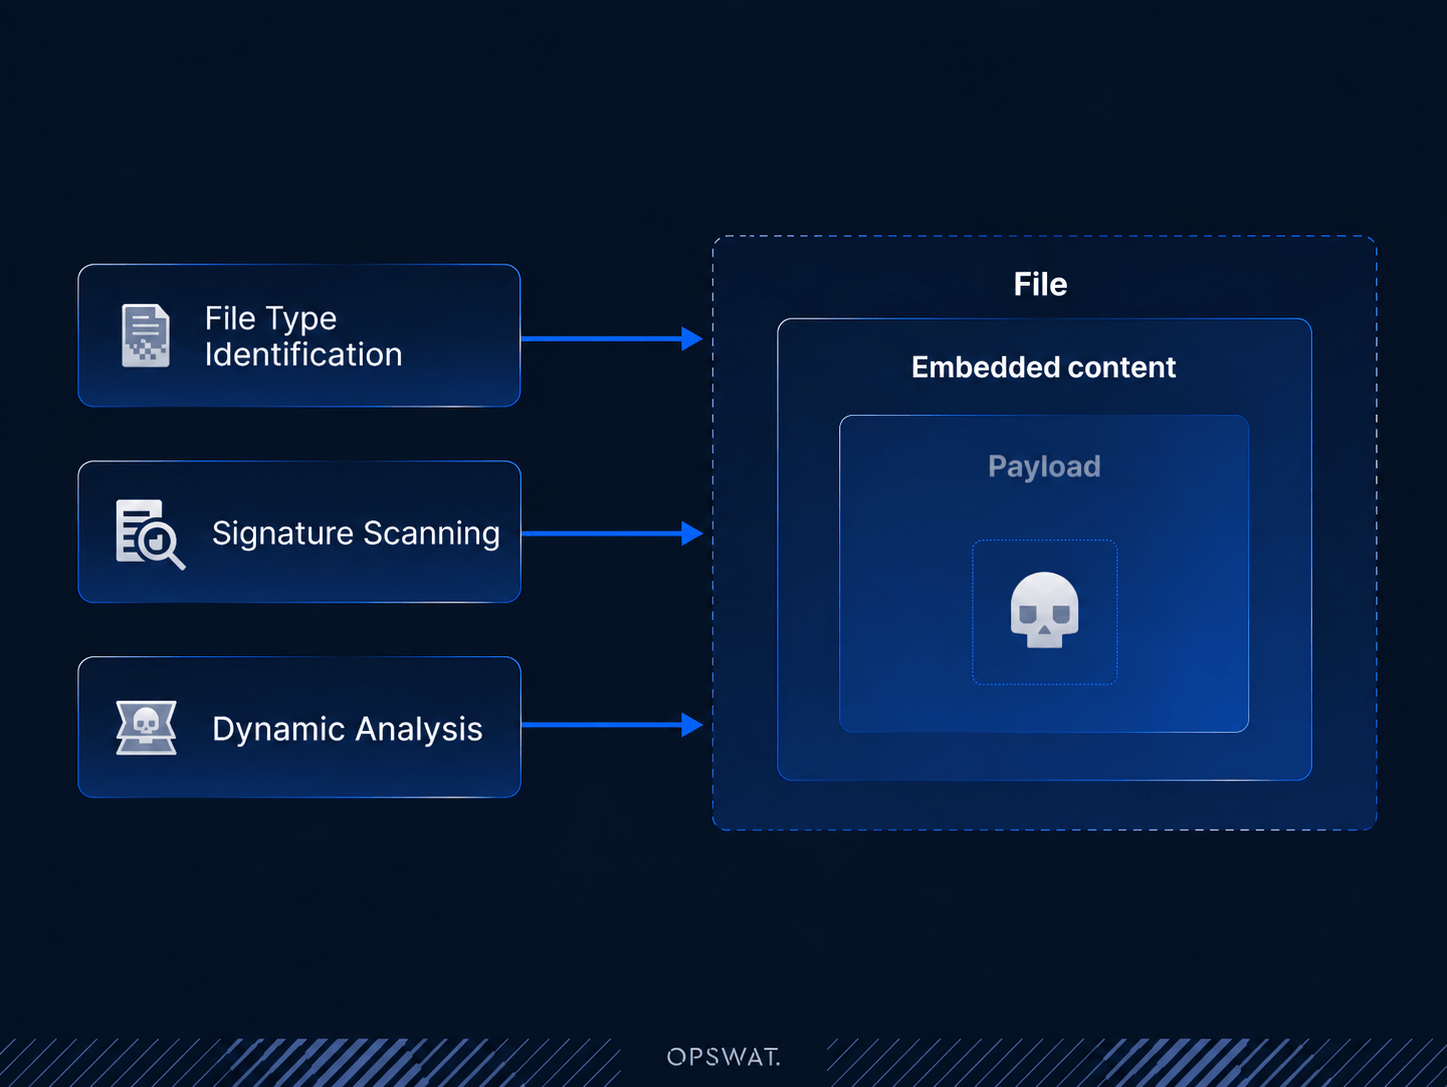
Cada capa cumple su función, pero cuando una carga útil nunca se separa del archivo que la transporta, o se encuentra por debajo de un límite de profundidad, ese contenido nunca llega a ninguna de estas capas, por lo que añadir capas adicionales no sirve para compensarlo. El punto ciego se propaga más en los formatos que carecen por completo de una ruta de saneamiento: archivos de bases de datos, datos SIG, archivos de modelos de IA. Esos formatos no se pueden reconstruir, por lo que la capa que normalmente detectaría una amenaza desconocida no está disponible por definición.
La pieza que falta es una capa cuya única función sea establecer primero la realidad estructural de referencia: analizar un archivo según su especificación de formato, extraer todos los componentes incrustados y poner dichos componentes a disposición, de forma individual, de todos los procesos posteriores. Ese es el problema que la validación de la estructura de archivos se diseñó para resolver.
Cómo la validación de la estructura de archivos acorta la brecha
La validación de la estructura de archivos se ejecuta antes de que entre en funcionamiento el resto de la pila. Comprueba que un archivo se ajuste a su especificación de formato en más de 160 tipos de archivo, incluidos formatos SIG, de bases de datos y de modelos de IA; lo descompone en sus componentes y aplica la política correspondiente a cada uno de ellos.
Los objetos se envían al motor adecuado para su análisis: Metascan™ Multiscanning, Adaptive ,Sandbox, la tecnología Proactive DLP™ o OPSWAT Alin AI. El archivo original se envía a la tecnología Deep CDR™ para su depuración, cuando proceda.
Lo que importa aquí es el efecto que tiene en el análisis. La comparación de firmas sigue siendo la forma más rápida y económica de identificar el malware conocido, y la validación de la estructura de archivos no sustituye en absoluto ese trabajo. Lo que cambia es lo que se proporciona a los motores. La carga útil llega como un archivo independiente, ya descomprimido y clasificado, por lo que el motor compara el objeto en sí mismo en lugar de un fragmento comprimido oculto dentro de un archivo principal. A los motores de detección se les proporcionan los bytes exactos que sus bases de datos están diseñadas para reconocer, y en ese momento hacen lo que siempre han hecho bien.
Verlo en un archivo
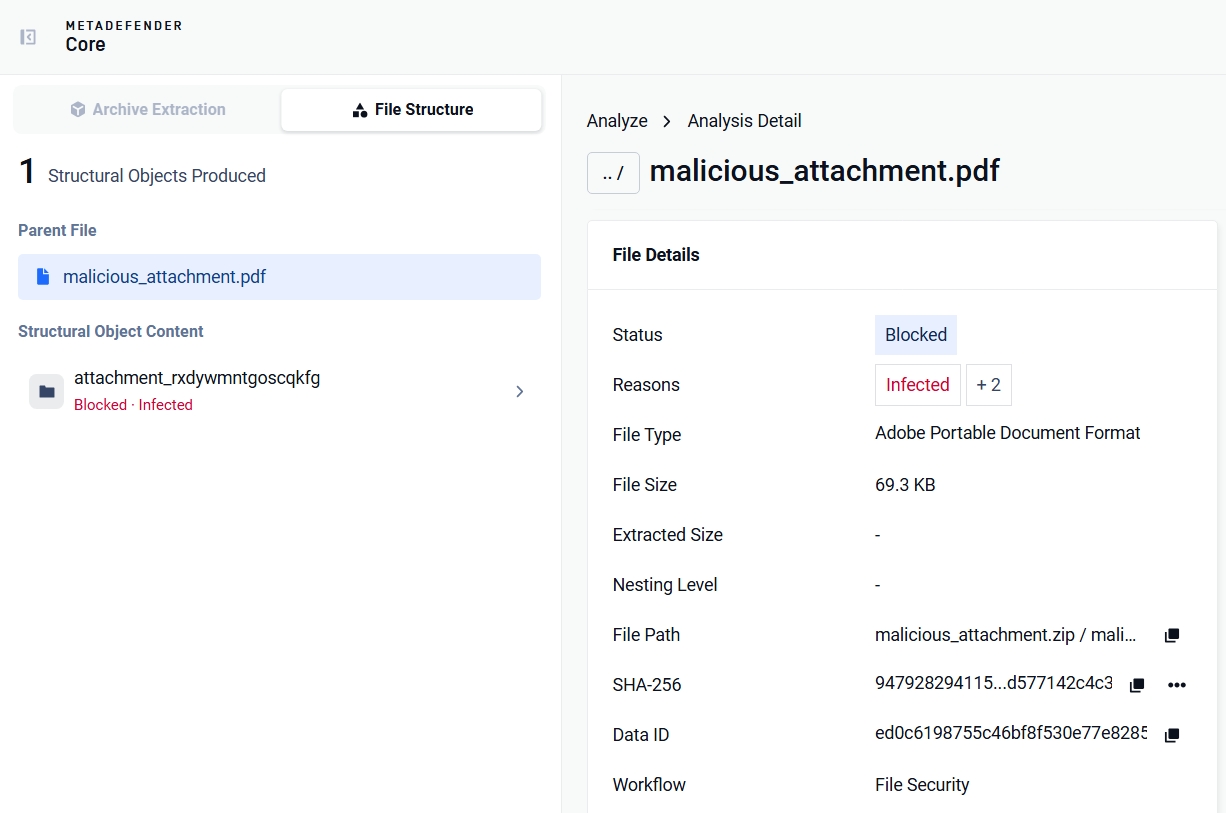
La forma más clara de demostrarlo es un archivo que supera el análisis y, aun así, contiene una carga maliciosa. Creamos una prueba de concepto en la que se oculta una carga maliciosa dentro de un archivo PDF inofensivo. A continuación, la muestra se sometió a una serie de motores antimalware, que dieron como resultado que estaba limpia.
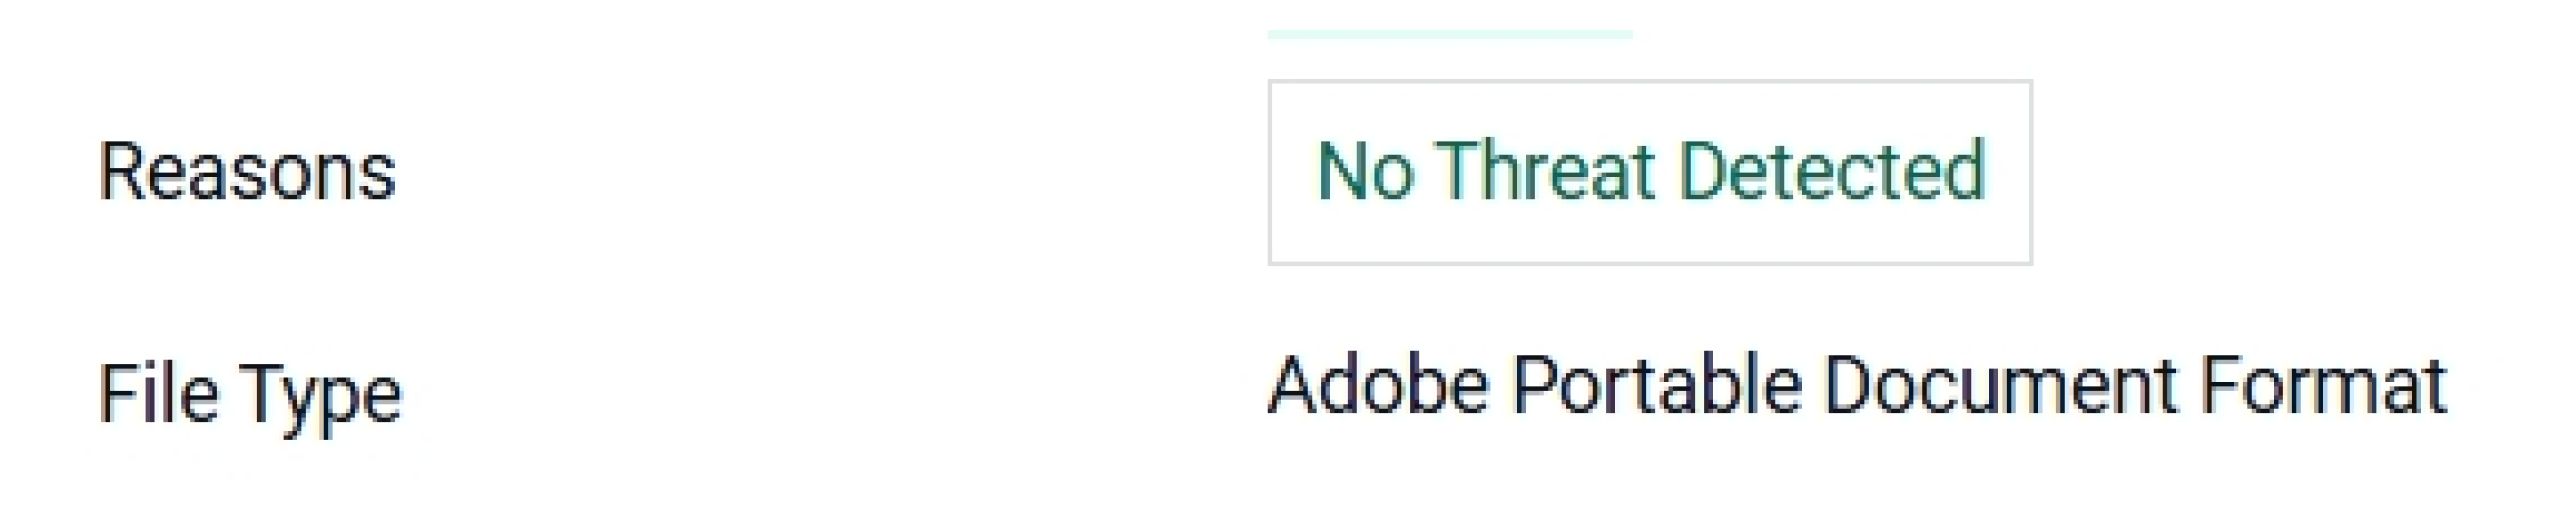
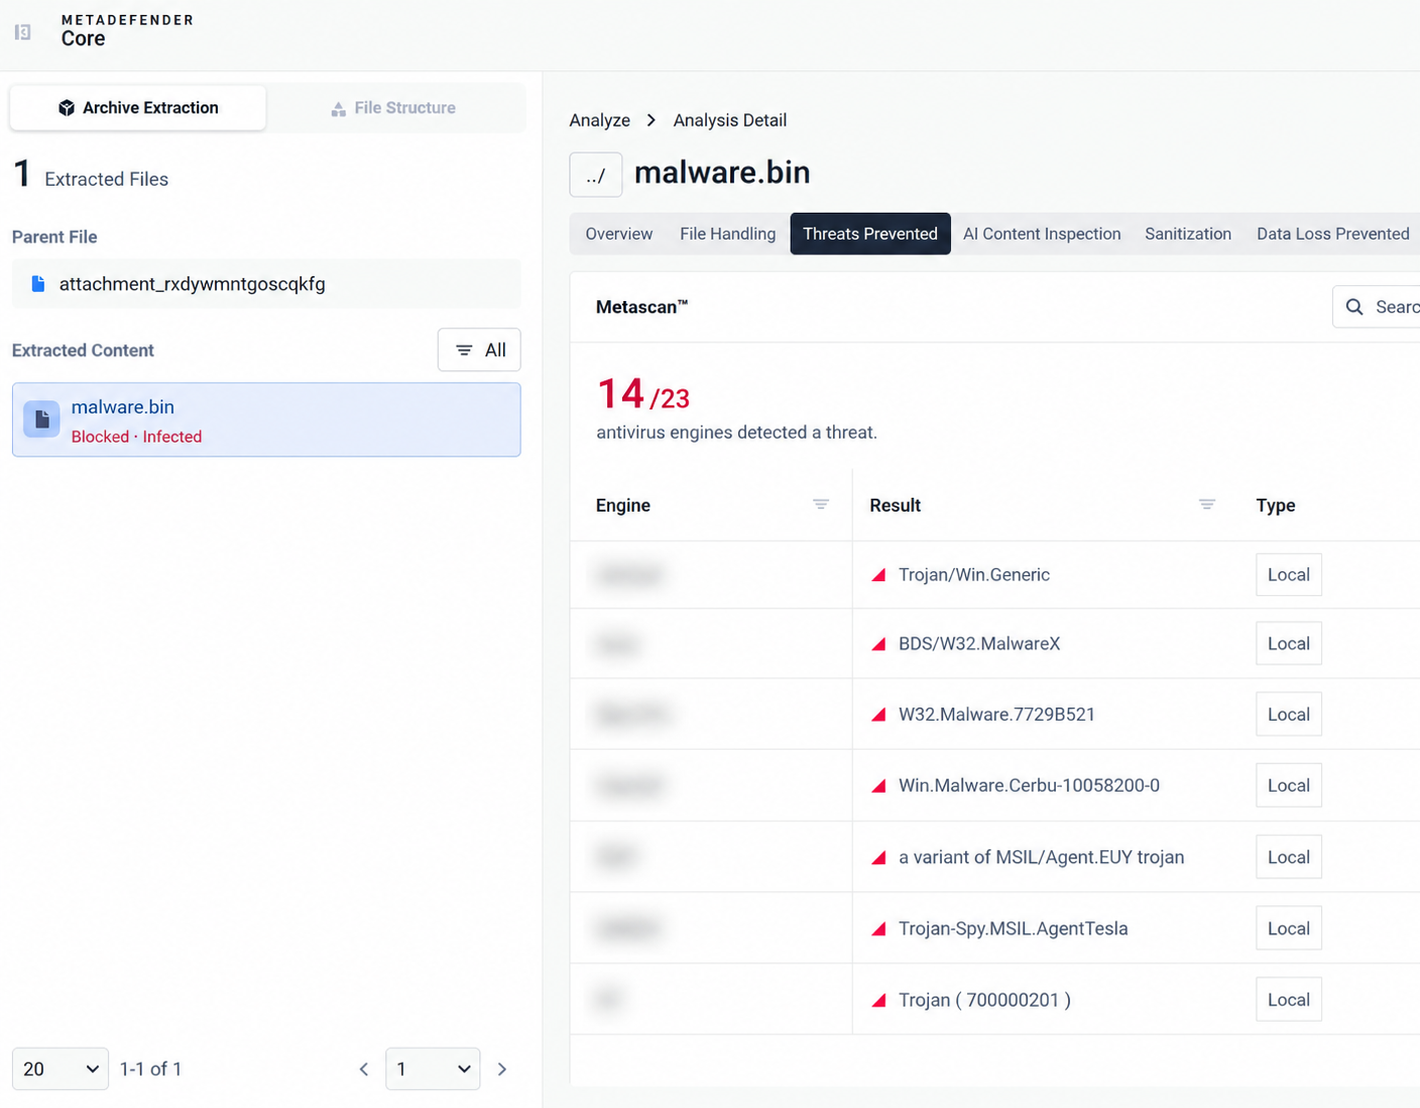
El siguiente paso consiste en escanear este archivo en MetaDefender Core™ con la validación de la estructura de archivos activada. Tras extraer los componentes anidados del archivo principal, la validación de la estructura de archivos envía los objetos resultantes a los motores posteriores para su análisis posterior.
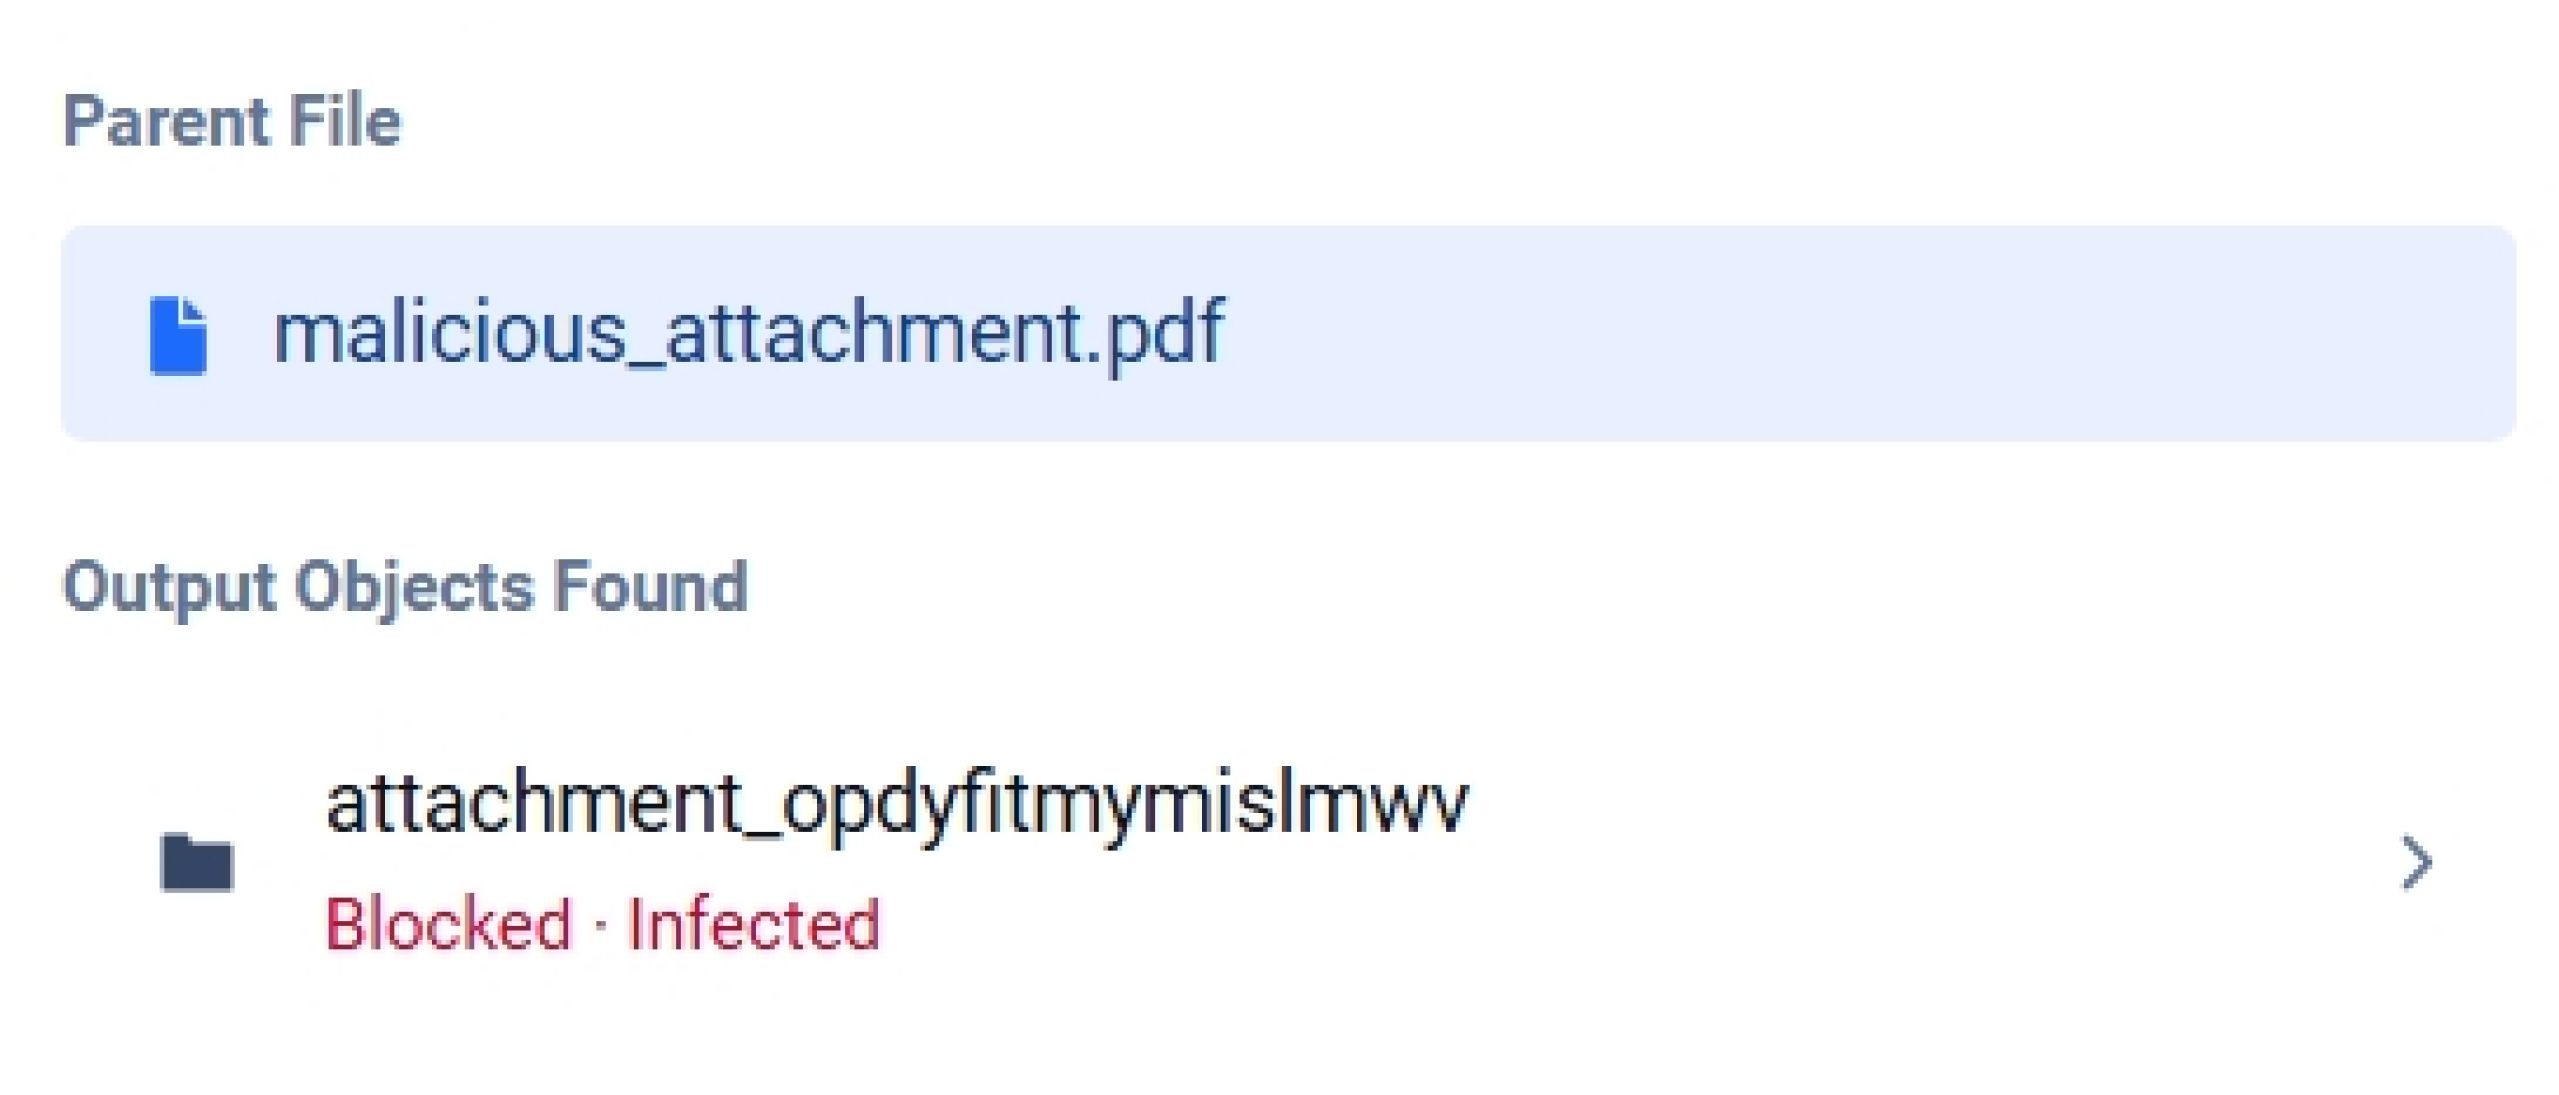
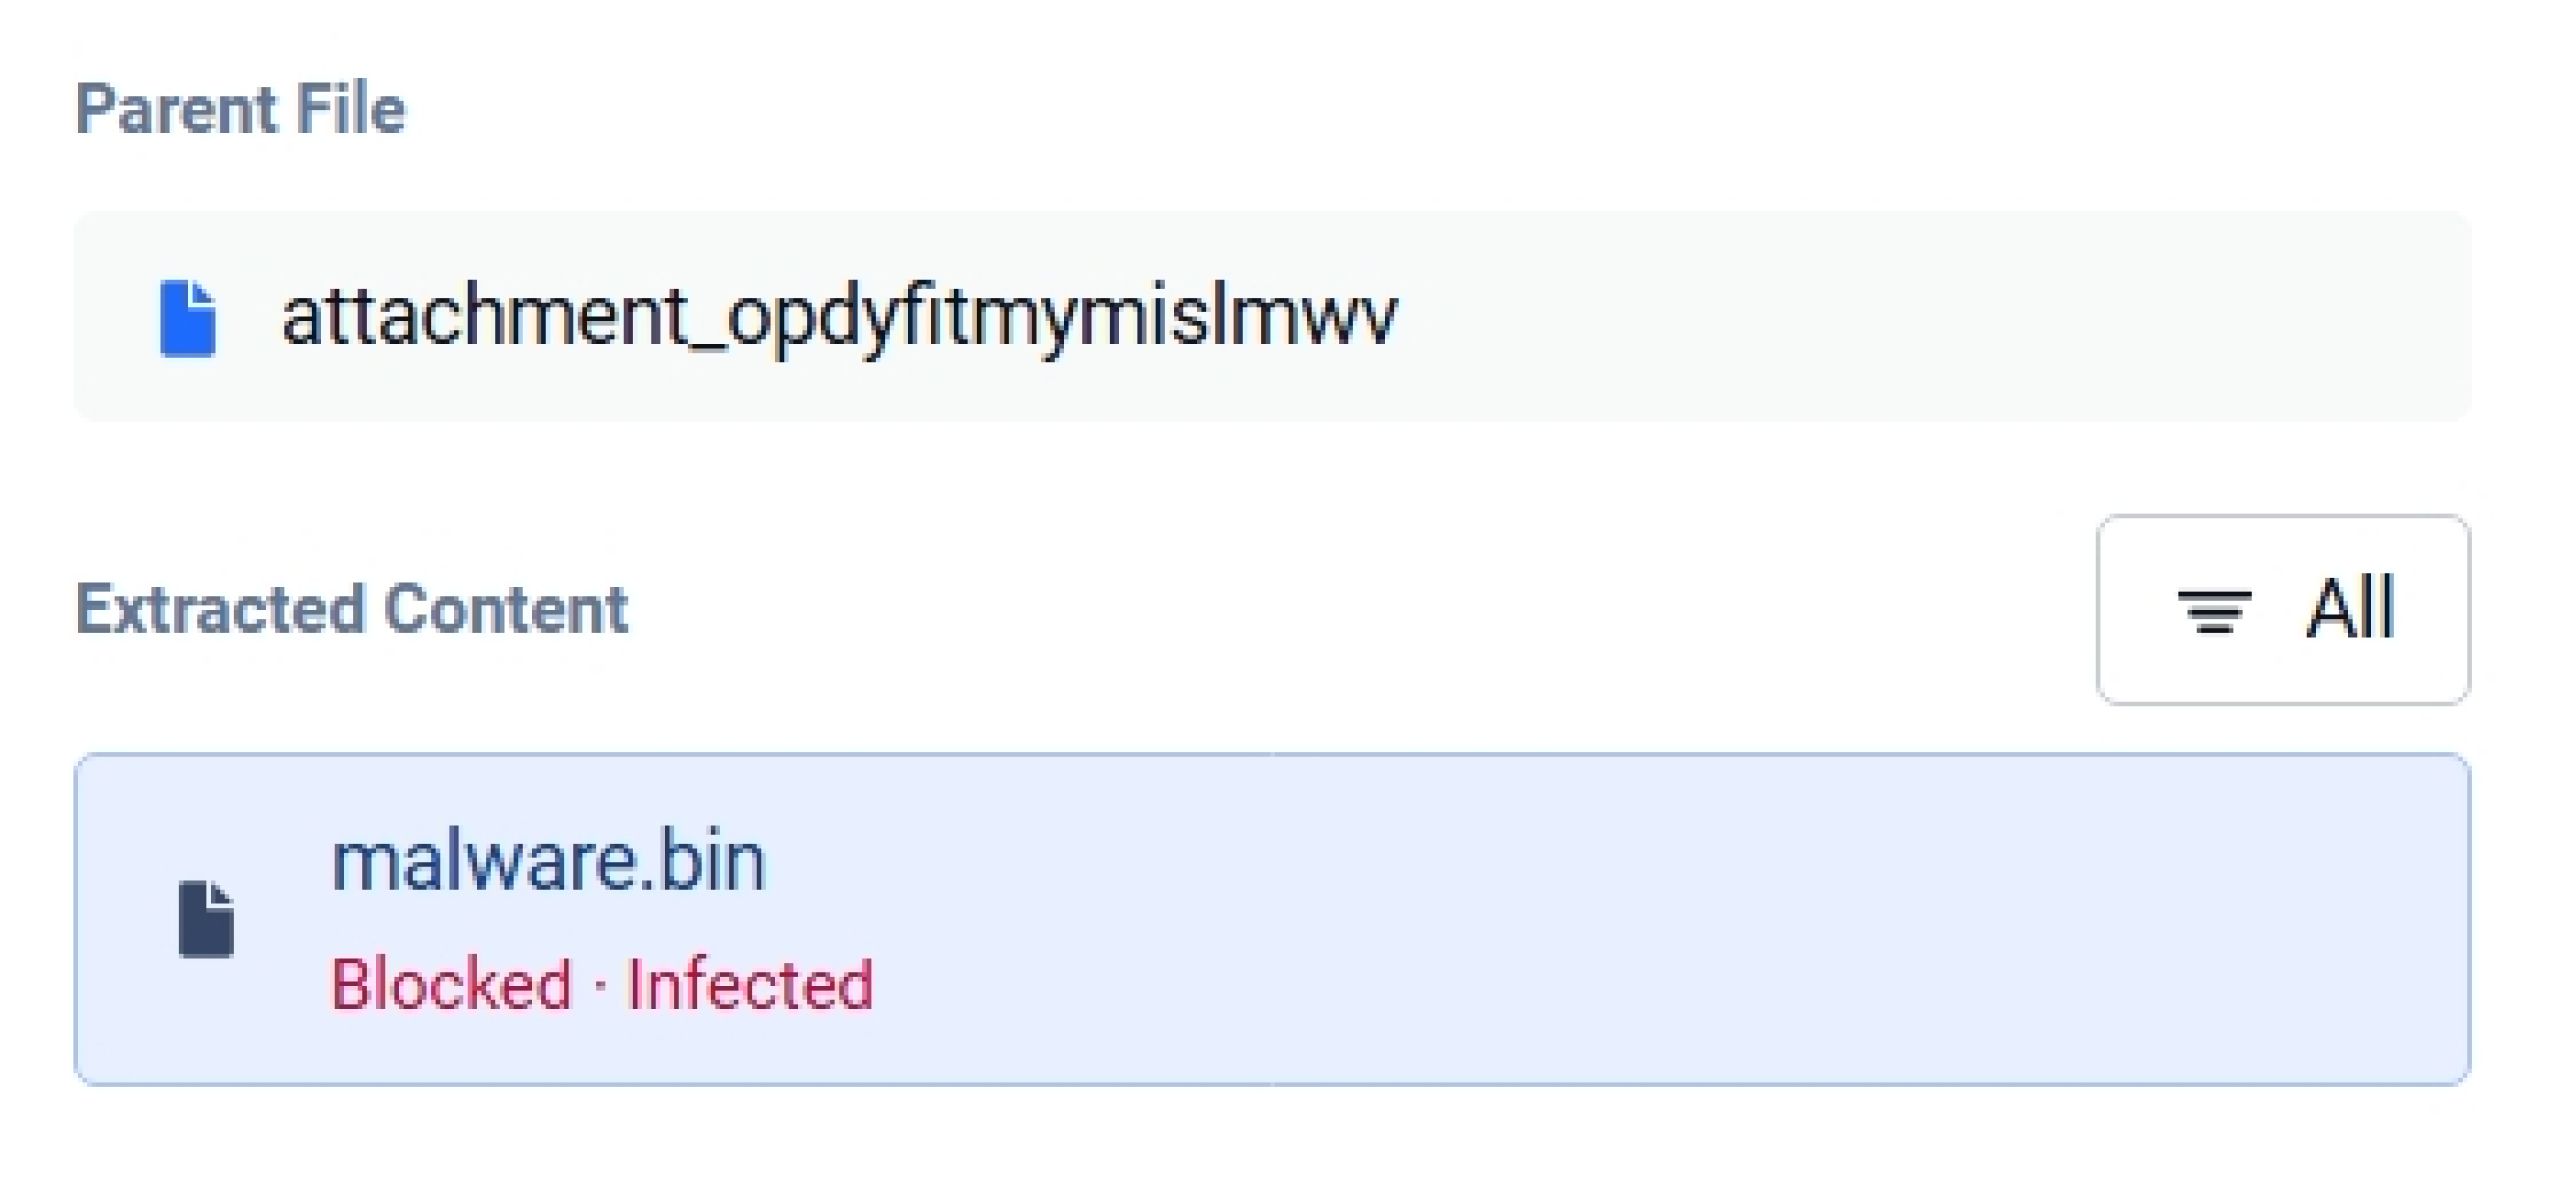
Los motores antimalware de Metascan™ Multiscanning emitieron un veredicto de «Infectado». Las mismas bases de datos de firmas que no habían detectado ninguna amenaza señalaron una infección en cuanto la carga útil se presentó como un archivo independiente.
Por dónde empezar
Un análisis limpio es una indicación de lo que un motor podría analizar. Que el archivo contenga algo peligroso es otra cuestión, y responder a ella supone un problema estructural que debe resolverse antes de que se ejecute el primer motor de detección.
Que esto implique una validación de la estructura de archivos por sí sola o junto con la depuración y el análisis dinámico depende de tus tipos de archivo, tus flujos de trabajo y tus requisitos de integridad. Consúltanos para saber qué combinación se adapta mejor a tu entorno.